Öffentliche Stellenausschreibungen von Notion, Stripe und Gusto weisen Supportmitarbeitenden explizite Aufgaben bei der Diagnose von Kundenproblemen, der Reproduktion von Fehlern und der Bündelung von Kontext für Entwicklungsteams zu. Während diese Ausschreibungen eher Rollengrenzen als interne Softwarefähigkeiten beschreiben, wirft diese wiederkehrende Übergabestruktur eine wichtige operative Frage auf: Wie können Engineering-Organisationen interne Produkte gestalten, die die technische Triage unterstützen, ohne die erforderliche menschliche Verifikation zu umgehen?
Was die Stellenanzeigen zeigen
Technische Stellenanzeigen beschreiben konkrete Aufgaben für Support- und Kundenbetreuungsteams. Eine Anzeige für einen Enterprise Technical Support Engineer nennt diese Aufgabe: 'Reproduce customer issues, perform initial codebase triage, and file bugs with Engineering' Sie verbindet die Fehlerreproduktion, die erste Prüfung der Codebasis und die Erstellung von Tickets für die Entwicklung.
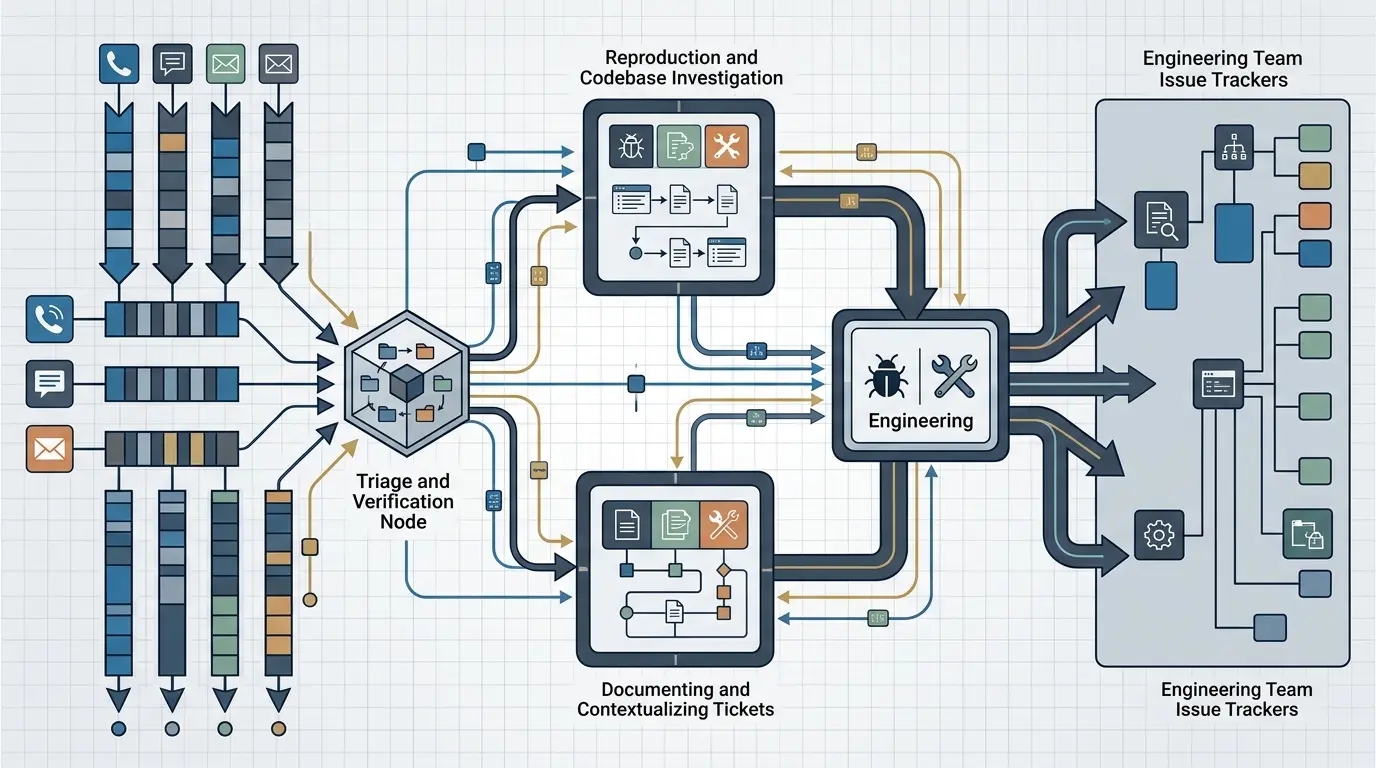
Eine Stripe-Anzeige für einen Technical Support Engineer (Metronome) nennt diese Aufgabe: 'Troubleshoot any issues that arise from customers and diagnose any blockers. Escalate issues with customer context to the engineering team.' Diagnose und Kontextübergabe sind hier Teil der Eskalation.
Eine Gusto-Anzeige für einen Retirement Client Relationship Manager nennt folgende Aufgabe: 'Triage, troubleshoot, and resolve customer issues, escalating technical bugs to Engineering with clear, well-documented tickets and following through to resolution' In allen drei Beispielen sollen Mitarbeitende gemeldete Kundensymptome in Informationen für die Entwicklung überführen.
- Notion: Reproduzieren von Problemen, Durchführen einer ersten Triage in der Codebasis und Erfassen von Fehlern für das Engineering.
- Stripe: Fehlerbehebung bei Kundenblockern und Eskalation von Problemen unter Beifügung des Kundenkontexts.
- Gusto: Triage und Behebung von Problemen bei gleichzeitiger Eskalation technischer Fehler über gut dokumentierte Tickets.
Fehler an die Entwicklung übergeben
Die Analyse dieser Stellenausschreibungen verdeutlicht ein einheitliches operatives Muster: die Übergabegrenze zwischen Kundenkommunikationskanälen und Issue-Trackern der Entwicklung. Das Vorkommen dieser Aufgaben in Stellenbeschreibungen bestätigt, dass Organisationen menschliche Fachkräfte damit betrauen, mehrdeutige Kundenberichte zu interpretieren, den zugrunde liegenden technischen Zustand zu untersuchen und Erkenntnisse für Entwicklungsteams zusammenzufassen.
Eine ausgeschriebene Verantwortung lässt jedoch keinen Rückschluss darauf zu, ob einem Unternehmen interne Software fehlt oder ob es über maßgeschneiderte Tools verfügt. Eine Stellenanforderung belegt weder das Fehlen noch das Vorhandensein individueller Triage-Anwendungen, noch gibt sie Aufschluss über Teamgröße, Ticketvolumen, Fehlerraten oder Workflow-Kosten. Sie bestätigt lediglich, dass das menschliche Urteilsvermögen die primäre operative Brücke zwischen externen Kundenproblemen und interner technischer Reaktion bleibt.
Um die wirtschaftlichen Abwägungen beim Aufbau maßgeschneiderter Triage-Pipelines zu bewerten, lesen Sie unsere Analyse der Kostenstrukturen von Workflow-Automatisierungen. Kostenfaktoren der Workflow-Automatisierung.
Welche internen Daten Sie prüfen sollten
Wenn eine Organisation verstehen möchte, wie dieses Muster innerhalb ihrer eigenen Grenzen wirkt, muss sie konkrete empirische Belege sammeln, anstatt Annahmen zu treffen. Um die Effizienz von Übergaben zu verstehen, muss der gesamte Lebenszyklus technischer Eskalationen untersucht werden.
Überprüfen Sie eine autorisierte, repräsentative Stichprobe von Eskalationen. Messen Sie den Zeitaufwand für die Kontextsuche, Rückfragen zur Klärung und erfolglose Reproduktionsversuche. Trennen Sie fehlende Informationen von Fehlern, die tatsächlich eine Untersuchung durch die Entwicklung erfordern; wiederholte Übergaben können Zuständigkeits- oder Kapazitätsprobleme widerspiegeln, die Software allein nicht löst.
Ein Produkt und eine Fehlerkategorie
Wenn die gemessenen Reibungsverluste bei Übergaben Änderungen rechtfertigen, vergleichen Sie native Ticket-Vorlagen und unterstützte Integrationen zunächst mit einer kleinen individuellen Erweiterung. Eine vorgeschlagene Workbench kann den zulässigen Diagnosekontext und einen Ticketentwurf für ein einzelnes Produkt und eine Problemkategorie zusammenstellen. Vereinbaren Sie vor der Implementierung das empfangende Team, die erforderlichen Nachweise und die Akzeptanzkriterien.
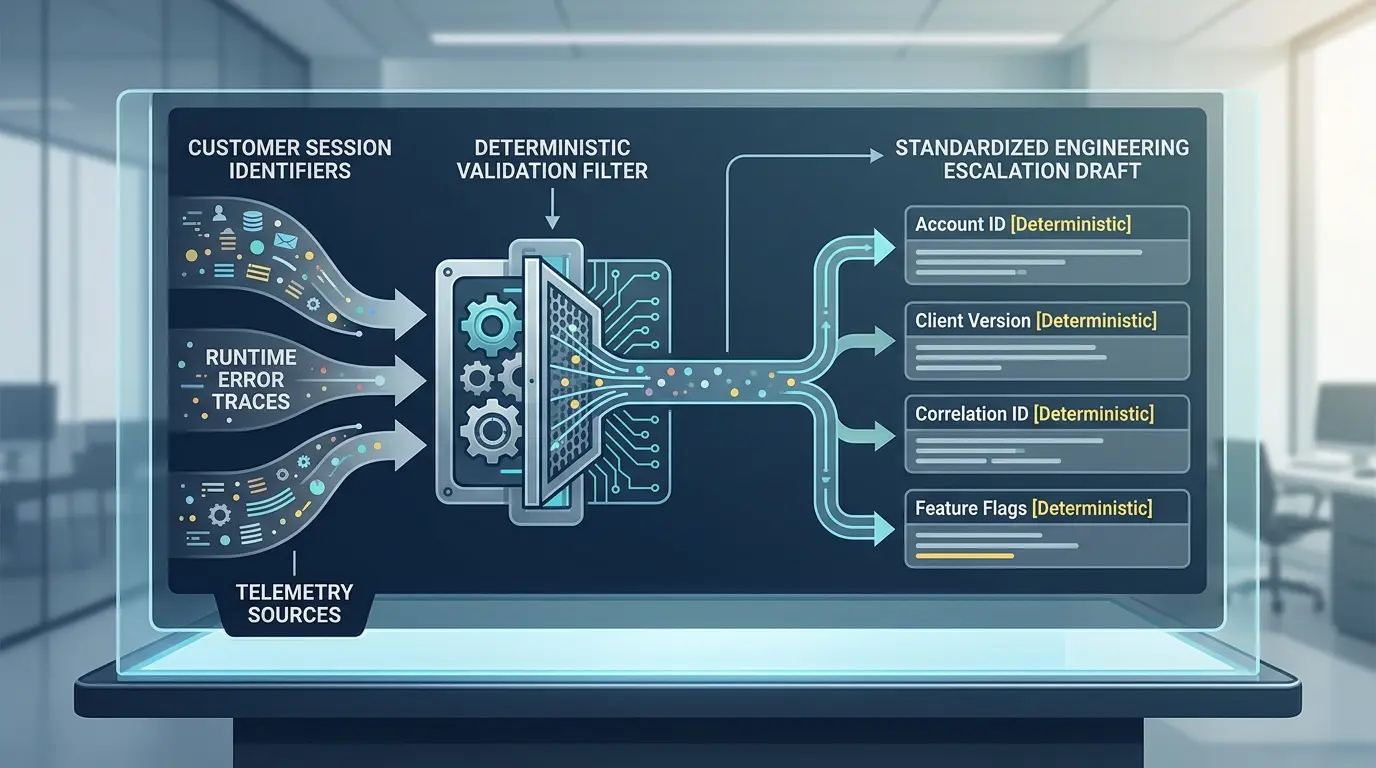
Nutzen Sie autorisierte Integrationen, um das Minimum an erforderlichen Diagnosefeldern für das ausgewählte Problem abzurufen. Überprüfen Sie den Konto- und Mandantenzugriff, bevor Sie Sitzungsbezeichner mit Protokollen korrelieren; ein in einer Nachricht übermittelter Wert ist kein Nachweis für eine Zugriffsberechtigung. Bereinigen Sie Geheimnisse und unnötige personenbezogene Daten, behalten Sie Quellverweise bei und kennzeichnen Sie fehlende oder veraltete Telemetriedaten. Kopieren Sie standardmäßig keine vollständigen Kundensitzungen in ein Modell oder einen Issue-Tracker.
Organisationen, die prüfen, ob Standard-Ticketing-Plattformen ihre Diagnoseanforderungen erfüllen, können unseren Vergleich zwischen individueller Software und Standard-SaaS einsehen. Individuelle Software versus Standard-SaaS.
Erst Felder prüfen, dann KI ergänzen
Validieren Sie bekannte Felder, bevor modellgenerierter Text hinzugefügt wird: Account-Zuordnungen, Anwendungsversionen, relevante Feature-Flags, Ereigniszeitstempel und die Umgebung, in der eine Beobachtung gemacht wurde. Exaktes Parsen beweist nicht, dass die zugrunde liegenden Daten oder Korrelationen korrekt sind. Erfassen Sie Unsicherheiten und unterscheiden Sie Beobachtungen aus der Produktion von kontrollierten Reproduktionsversuchen.
Ein Modell kann autorisierte Dialoge zusammenfassen oder einen Entwurf für eine Untersuchungsabfolge vorschlagen, aber es kann nicht feststellen, ob ein Fehler reproduziert wurde. Kennzeichnen Sie generierte Schritte als ungeprüft, bis eine Fachkraft sie anhand der Quelle überprüft und das Problem gegebenenfalls in einer autorisierten Testumgebung reproduziert. Die Trennung strukturierter Felder von generiertem Text verringert Unklarheiten; sie verhindert jedoch keine Halluzinationen und garantiert keine korrekte Telemetrie. Behandeln Sie Kundennachrichten als nicht vertrauenswürdige Eingaben, nicht als auszuführende Anweisungen.
Die Abwägung deterministischer Regeln gegenüber der Generierung durch Sprachmodelle wird in unserem Leitfaden zu KI-Agenten im Vergleich zu Workflow-Automatisierungsarchitekturen ausführlich beschrieben. KI-Agent versus Workflow-Automatisierung.
Prüfung und dringende Ausnahmen
Die Workbench sollte eine nachvollziehbare Überprüfung gewährleisten, bevor ein Engineering-Ticket eingereicht wird. Die prüfende Person benötigt die ursprünglichen Beobachtungen, fehlende Nachweise und die Befugnis, einen Vorschlag abzulehnen. Halten Sie bestehende Eskalationspfade für dringende Vorfälle und Sicherheitsfragen verfügbar; lassen Sie Einsatzkräfte nicht auf die KI-Verarbeitung warten, bevor sie diese Verfahren befolgen.
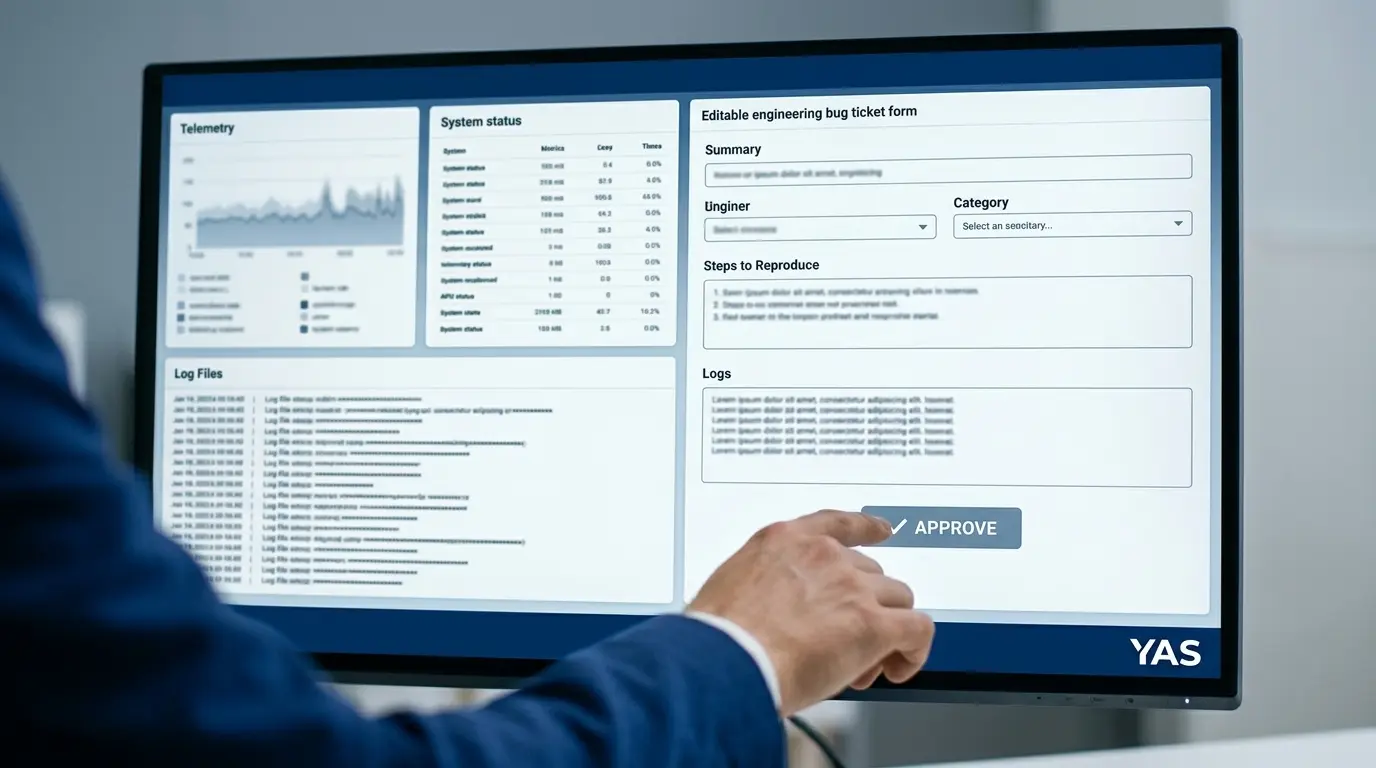
Die Fachkraft prüft die Belege, unterscheidet beobachtete von vorgeschlagenen Schritten, wählt den Schweregrad gemäß der vereinbarten Richtlinie aus und bestätigt das Ziel. Führen Sie einen geschützten Verlauf von Ereignisreferenzen, relevanten Verarbeitungsversionen, vorgeschlagenen Feldern, Änderungen durch Prüfende und dem Ergebnis der Einreichung. Kontrollieren Sie Zugriff und Aufbewahrung, schließen Sie Zugangsdaten sowie unnötige Rohprotokolle aus und testen Sie Duplikaterkennung sowie die Wiederherstellung bei fehlgeschlagenen Einreichungen. Ein Protokoll oder ein Freigabebutton allein garantiert keine fehlerfreie Übergabe.
Die erste Umsetzung eingrenzen
Bevor Sie ein Triage-Tool in Auftrag geben, prüfen Sie, ob bestehende Ticket-Vorlagen, native Integrationen und klarere Zuständigkeiten das gemessene Problem lösen. Vergleichen Sie Implementierungs- und Betriebskosten mit dem Zeitaufwand für das Sammeln von Belegen und das Prüfen von Eskalationen. Eine maßgeschneiderte Integration kommt nur bei einer spezifischen, ungedeckten Anforderung infrage, nicht bloß deshalb, weil der Prozess manuelle Arbeit enthält.
Um die erste Automatisierung einzugrenzen, beschreiben Sie den Supportkanal, den Issue-Tracker, Diagnosetools, das ungefähre wöchentliche Volumen und das wiederkehrende Übergabeproblem. Nutzen Sie anonymisierte Beispiele ohne Kundenprotokolle, Zugangsdaten oder privaten Code. Wir können die Konfiguration vorhandener Werkzeuge mit einer begrenzten individuellen Integration vergleichen, Anforderungen an Nachweise und Prüfungen definieren sowie einen Pilotbetrieb mit manuellem Ersatzablauf, Abnahmetests und Übergabedokumentation vereinbaren. Die zitierten Stellenanzeigen belegen weder Kundenprojekte von YAS noch gemessene Einsparungen.
Bei der Strukturierung einer internen Triage-Workbench können sich Engineering-Teams an Prinzipien für die zielgerichtete Abgrenzung eines MVP orientieren. Abgrenzung eines MVP ohne Mehraufwand.
| Unternehmen | Rolle | Exakte ausgeschriebene Aufgabe | Was sich daraus ableiten lässt | Quelle / Zugriffsdatum |
|---|---|---|---|---|
| Notion | Enterprise Technical Support Engineer | Reproduce customer issues, perform initial codebase triage, and file bugs with Engineering | Weist der Rolle die Verantwortung für die Fehlerreproduktion, die Triage in der Codebasis und die Erstellung von Fehlerberichten zu. | 2026-04-27 (Ashby Job Board) |
| Stripe | Technical Support Engineer, Metronome | Troubleshoot any issues that arise from customers and diagnose any blockers. Escalate issues with customer context to the engineering team. | Weist der Rolle die Verantwortung für die Fehlerbehebung bei Kundenblockern und die Weitergabe des Kontexts an das Engineering zu. | 2026-08-18 (Stripe Careers) |
| Gusto | Future Opportunities: Retirement Client Relationship Manager | Triage, troubleshoot, and resolve customer issues, escalating technical bugs to Engineering with clear, well-documented tickets and following through to resolution | Weist der Rolle die Verantwortung für Fehlerbehebung, das Lösen von Kundenproblemen und die Dokumentation von Bug-Tickets für das Engineering zu. | 2026-08-14 (Greenhouse Job Board) |
Checkliste für die Fehlerübergabe
- Messen Sie Rückfragen in einer autorisierten Stichprobe gemeldeter Fehler anhand minimaler Metadaten und anonymisierter Beispiele, anstatt private Unterhaltungen in die Bewertung zu kopieren.
- Messen Sie den Prozentsatz der Kunden-Eskalationstickets, die manuelle Log-Abfragen über separate Schnittstellen hinweg erfordern.
- Erfassen Sie die genauen Felder, die Engineering-Teams benötigen, um einen gemeldeten Fehler erfolgreich zu reproduzieren.
- Überprüfen Sie aktuelle Fehlerraten bei der Reproduktion, bei denen das Engineering Tickets aufgrund unvollständigen Kontexts an den First-Level-Support zurückgibt.
- Berechnen Sie die Latenz zwischen der ersten Einreichung der Kundenmeldung und der Erstellung eines verifizierten Bug-Tickets im Engineering-Tracker.
- Prüfen Sie, ob verifizierte Account- und Mandanten-Zuordnungen eine Korrelation mit den erforderlichen Diagnoseereignissen ermöglichen; verlangen Sie eine Überprüfung bei uneindeutigen oder fehlenden Übereinstimmungen, anstatt eine kopierte Kennung als Autorisierung zu behandeln.
- Bewerten Sie, ob Support-Spezialisten derzeit Triage-Hypothesen auf Code-Ebene bearbeiten oder verfassen, bevor sie Tickets erstellen.
- Überprüfen Sie interne Compliance- und Datenschutzgrenzen bezüglich der Extraktion von Kunden-Logs bei technischen Eskalationen.
Reproduce customer issues, perform initial codebase triage, and file bugs with Engineering
Häufige Fragen
Beweisen diese Stellenanzeigen, dass Notion, Stripe oder Gusto über keine interne Software zur Bug-Eskalation verfügen?
Nein. Stellenausschreibungen definieren Aufgaben, erforderliche Fähigkeiten und operative Verantwortlichkeiten für einzelne Rollen. Sie dokumentieren weder interne Systemarchitekturen noch den Reifegrad von Tools oder das Vorhandensein proprietärer Eskalationssoftware.
Was ist der Unterschied zwischen deterministischer Datenextraktion und KI-gestützter Triage?
Deterministische Extraktion wendet explizite Regeln auf ausgewählte Felder wie Fehlercodes, Zeitstempel und verifizierte Account-Zuordnungen an. Diese Felder können dennoch unvollständig oder fehlerhaft korreliert sein. KI-Unterstützung kann autorisierten Text zusammenfassen oder eine Untersuchungsreihenfolge vorschlagen, doch vorgeschlagene Reproduktionsschritte bleiben unverifiziert, bis sie anhand von Nachweisen geprüft werden. Weder Parsing noch Generierung beweisen, dass ein Fehler reproduziert wurde.
Warum sollten Organisationen einen menschlichen Kontrollpunkt in technischen Eskalations-Pipelines beibehalten?
Ein Prüfer kann geschäftliche Auswirkungen bewerten, die Quelldaten prüfen und beobachtetes Verhalten von einer generierten Hypothese trennen, bevor das Ticket eingereicht wird. Die Benutzeroberfläche muss Unsicherheiten aufzeigen und eine Ablehnung oder Eskalation ermöglichen. Eine menschliche Freigabe ist eine zu überprüfende Kontrollinstanz, keine Garantie für Korrektheit; etablierte Notfallverfahren sollten weiterhin verfügbar bleiben.
Wie kann ein Engineering-Team feststellen, ob sein Eskalationsprozess individuelle Software erfordert?
Messen Sie das Eskalationsvolumen, die Zeit zur Beweiserhebung, Klärungsanfragen und fehlgeschlagene Reproduktionsversuche, und testen Sie dann bestehende Vorlagen und Integrationen an denselben Fällen. Ziehen Sie eine begrenzte individuelle Erweiterung nur dann in Betracht, wenn eine wesentliche Anforderung unerfüllt bleibt und das Team Zugriffskontrollen, Wartung, Ausnahmebehandlung und Abnahmetests selbst übernehmen kann.
Können kommerzielle Standard-Ticketsysteme dieses Übergabemuster abbilden?
Ein kommerzieller Issue-Tracker deckt möglicherweise bereits die Erstellung, das Routing und die vom Team benötigte Diagnoseintegration ab. Testen Sie dessen unterstützte Funktionen, bevor Sie sich für ein individuelles Tool entscheiden. Spezifische Korrelations- oder Überprüfungsanforderungen können eine Erweiterung rechtfertigen, die Entscheidung sollte jedoch auf einem repräsentativen Test und einem Vergleich der Betriebskosten basieren, nicht auf der pauschalen Behauptung, Standardsysteme seien unzureichend.