In zahlreichen Stellenausschreibungen von Technologieunternehmen werden Spezialisten für Customer Operations damit betraut, eingehende Warteschlangen zu überwachen, Problembereiche zu klassifizieren und Tickets über funktionsübergreifende Grenzen hinweg weiterzuleiten. Die Analyse dieser ausgeschriebenen Aufgaben verdeutlicht eine zentrale Herausforderung beim Softwaredesign: Wie lassen sich Intake-Mechanismen so strukturieren, dass routinemäßiges deterministisches Routing von differenzierter diagnostischer Beurteilung getrennt wird?
Was die Stellenanzeigen zeigen
Aktuelle Stellenausschreibungen mehrerer Technologieunternehmen beschreiben ausdrückliche operative Aufgaben rund um das Management eingehender Warteschlangen und das Ticket-Routing. In einer Stellenausschreibung für Support Operations bei Stripe mit Fokus auf Privy heißt es, dass der Kandidat die Triage und das Routing für eingehende Support-Tickets sowohl von Privy-Entwicklern als auch von Endnutzern von Privy-Anwendungen übernimmt und sicherstellt, dass Probleme im Developer-Success-Team zeitnah und effizient zugewiesen, nachverfolgt und gelöst werden.
In ähnlicher Weise beschreibt Gusto operative Übergaben in zwei unterschiedlichen Rollen. In einer Anzeige für einen Relationship Manager im Bereich CX führt das Unternehmen die Verantwortung auf, technische Fehler mit klarer Dokumentation zu triagieren, zu analysieren und zu eskalieren, damit das Engineering-Team schnell reagieren kann. In einer weiteren Ausschreibung für einen People Process Transformation Lead wird die Leitung des HR Service Centers beschrieben, das für den Tier-0/1-Support für Gusties (Mitarbeiter) und People Empowerer (Führungskräfte) zuständig ist.
Bei Ramp beschreibt eine Ausschreibung für einen Customer Experience Associate den funktionsübergreifenden Charakter des Eskalationsmanagements. In der Stellenanzeige heißt es, wenn ein Problem Teamgrenzen überschreitet (wie Risiko, Engineering, Produkt oder Partnerschaften), leitet der Associate es korrekt weiter, hakt nach und stellt sicher, dass der Kunde nicht warten muss – und arbeitet dabei über Zendesk, interne Tools und Slack-basierte Eskalations-Workflows hinweg.
- Stripe spezifiziert das Routing eingehender Anfragen sowohl für Entwickler- als auch für Endnutzer-Personas.
- Gusto skizziert Wege zur Fehlereskalation direkt an Engineering-Teams parallel zu internen HR-Serviceabläufen.
- Ramp benennt eine bereichsübergreifende Koordination über Risiko-, Produkt-, Engineering- und Partnerkanäle hinweg.
Das zuständige Team finden
Ein berechtigter Rückschluss aus diesen Stellenbeschreibungen ist, dass Organisationen häufig spezialisierte Rollen oder zentrale Knotenpunkte einrichten, um zwischen der ungefilterten Eingangskommunikation und nachgelagerten operativen Teams zu vermitteln. Ob es sich um externe Kundensoftwarefehler, interne Mitarbeiteranfragen oder bereichsübergreifende Risikothemen handelt: Eingehende Vorgänge müssen kategorisiert, mit Kontextnotizen angereichert und an die zuständige Bearbeitergruppe weitergeleitet werden.
Stellenausschreibungen belegen, dass diese Zuständigkeiten existieren, sie beweisen jedoch nicht, dass es einer Organisation an Automatisierung fehlt oder sie über ineffiziente Tools verfügt. Eine explizite Stellenanforderung kann auf standardmäßige Governance, intensive Qualitätssicherung oder ein hohes Aufkommen an Grenzfällen hinweisen, die ständige menschliche Aufsicht erfordern. Das wiederkehrende Muster aus dem Lesen unstrukturierter Nachrichten, der Diagnose des Kernproblembereichs und der Aktualisierung sekundärer Ticketing-Plattformen verdeutlicht jedoch eine klassische Grenze der Systemarchitektur.
Verzögerungen bei Übergaben messen
Bevor ein Engineering-Team evaluiert, ob individuelle Software zur Unterstützung der Ticket-Triage entwickelt werden soll, muss es empirische Basiskennzahlen aus seinen bestehenden Kommunikationskanälen erfassen. Das Vorhandensein eines manuellen Triage-Workflows in Stellendokumentationen rechtfertigt für sich genommen noch keine Engineering-Initiative.
Messen Sie die Häufigkeit von Neuzuweisungen, die Zeit bis zur korrekten Warteschlange und Prioritätskorrekturen anhand einer autorisierten, repräsentativen Stichprobe. Trennen Sie vermeidbares Kopieren von Feldern von Verzögerungen, die durch unklare Zuständigkeiten, fehlende Informationen oder begrenzte Teamkapazitäten verursacht werden. Vergleichen Sie bestehende Helpdesk-Regeln und unterstützte Konnektoren, bevor ein manueller Schritt als Beleg dafür gewertet wird, dass individuelle Software erforderlich ist.
Vergleich von individueller Workflow-Software mit n8n-Automatisierung für geschäftskritische Routing-Pipelines. Individuelle Workflow-Software im Vergleich zu n8n-Automatisierung.
Ein Kanal, ein Anfragetyp, ein Team
Bleibt nach dem Test bestehender Werkzeuge ein gemessenes Routing-Problem bestehen, begrenzen Sie die erste Umsetzung auf einen Eingangskanal, einen Anfragetyp und ein empfangendes Team. Eine kleine Erweiterung kann Ereignisse prüfen, erforderliche Felder vereinheitlichen und vorgeschlagene Zuweisungen zur Prüfung vorlegen. Vereinbaren Sie Abnahmekriterien, Zugriffsrechte und einen manuellen Ersatzablauf, bevor Sie die direkte Weiterleitung aktivieren.
Rufen Sie nur den zulässigen Kontext ab, der für diese Routing-Entscheidung erforderlich ist. Überprüfen Sie Absender, Account und Organisationszuordnung über autorisierte Quellen; eine E-Mail-Domain oder eine Account-Kennung in einer Nachricht ist kein Nachweis für Zugriffsberechtigungen. Beginnen Sie im Prüfmodus. Erlauben Sie automatische Schreibvorgänge nur für ausdrücklich freigegebene Fälle, die getestete Geschäftsregeln, Duplikatschutz und Zielprüfungen bestehen, mit einem überwachten Wiederherstellungspfad für fehlgeschlagene Anfragen.
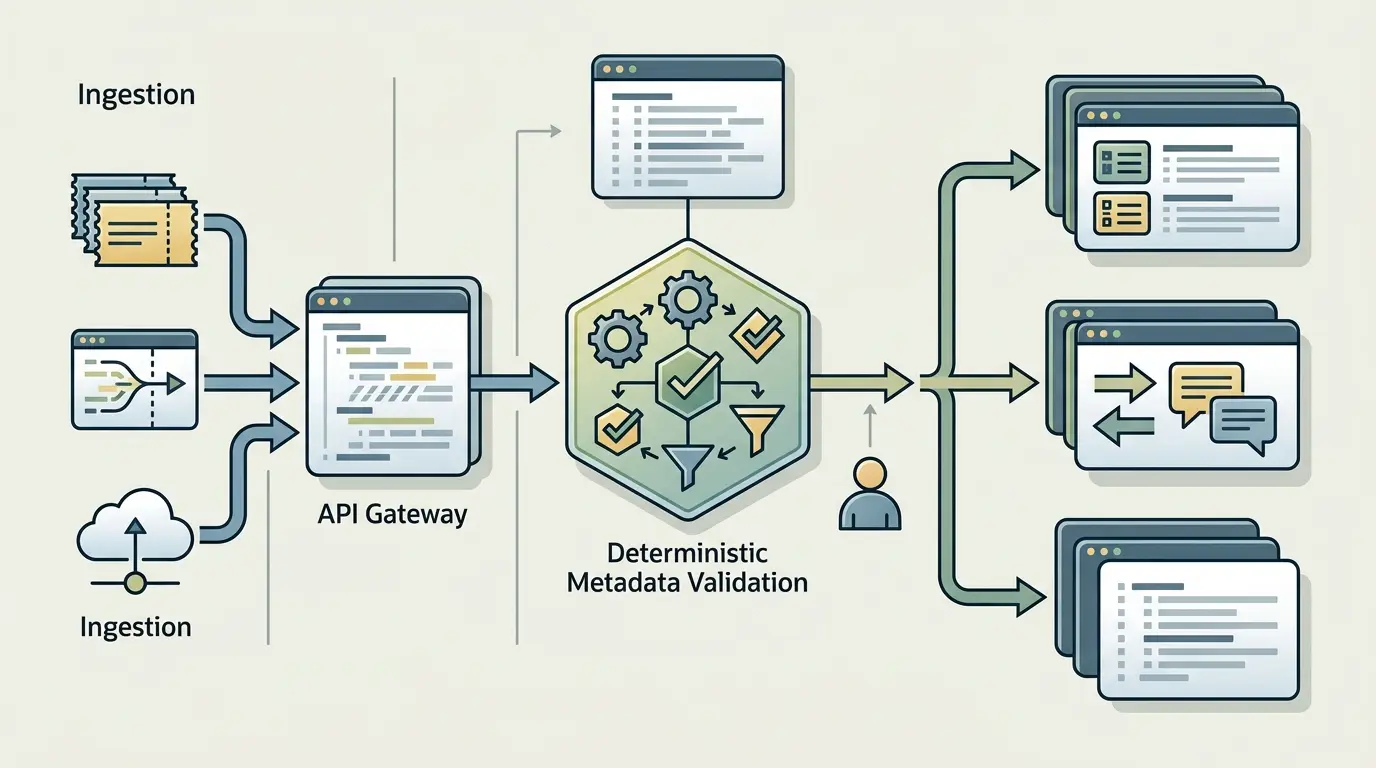
Individuelle Software für interne Abläufe prüfen: Individuelle Softwareentwicklung.
Erst Regeln und Daten, dann KI
Verwenden Sie explizite Regeln für bekannte Kontoattribute, vereinbarte Prioritätsrichtlinien und aktive Vorfallszustände, anstatt ein Sprachmodell zu bitten, diese zu erfinden. Überprüfen Sie Quelle, Aktualität und Berechtigungen dieser Felder. Eine deterministische Regel kann dennoch fehlerhaft weiterleiten, wenn ihre Konfiguration oder Eingabe falsch ist; testen Sie sie an repräsentativen Fällen und legen Sie fehlende oder widersprüchliche Werte offen.
Validieren Sie unterstützte Webhook-Signaturen, Replay-Schutz, Kontozuordnungen und den bestehenden Ticket-Status, bevor Sie den Routing-Kontext zusammenstellen. Behandeln Sie die Authentifizierung der Absenderdomäne nicht als Berechtigung zum Lesen von Kontodaten. Ein Modell darf zulässigen Fließtext zusammenfassen oder eine Kategorie vorschlagen, seine Ausgabe ist jedoch nicht vertrauenswürdig und darf keinen Zugriff gewähren, keine Eskalationsrichtlinien ändern und keine in Kundennachrichten eingebetteten Anweisungen ausführen. Vorgeschlagene Schritte zur Reproduktion bleiben ungeprüft, bis sie mit Nachweisen abgeglichen wurden.
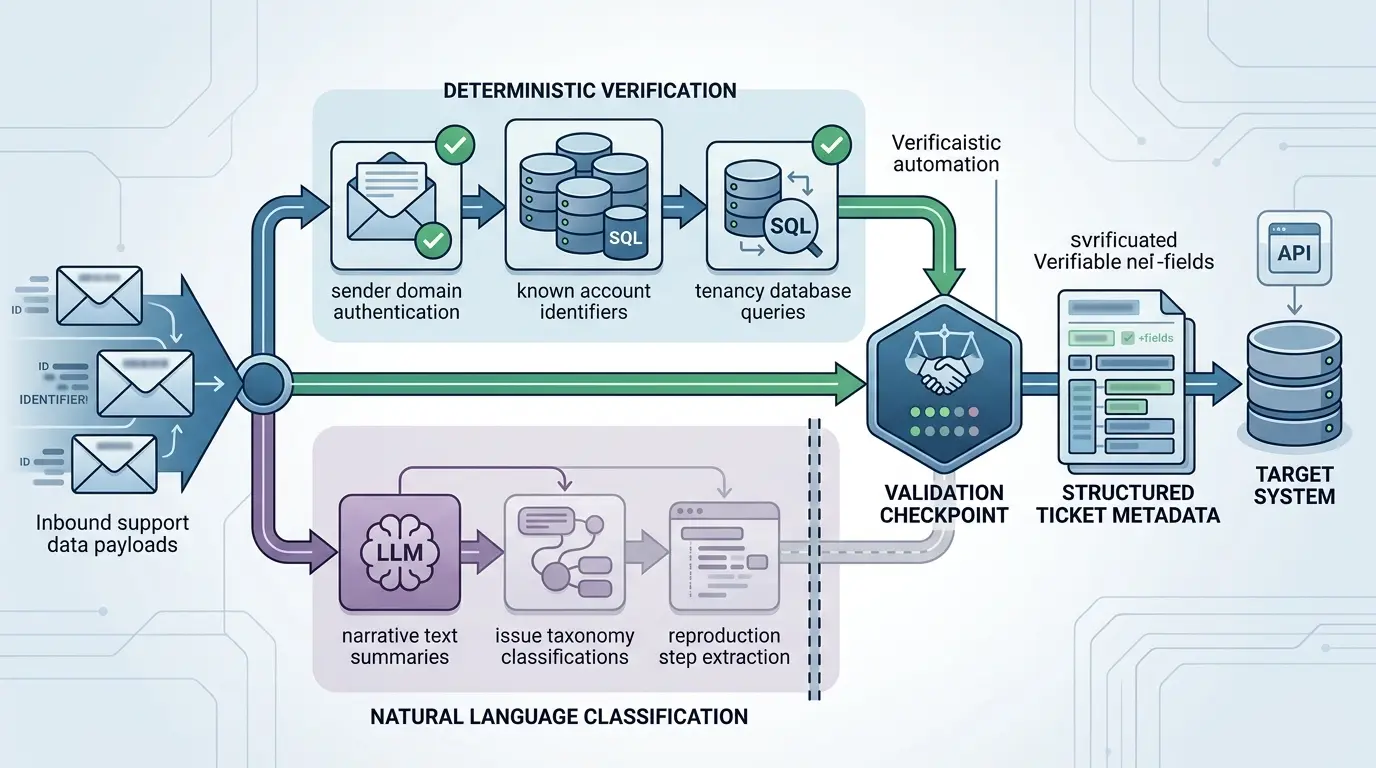
- Die Regelschicht prüft autorisierte Identifikatoren, Kontoattribute sowie den Vorfallsstatus und kennzeichnet fehlende, veraltete oder inkonsistente Daten.
- Regel-Engines gleichen bekannte Fehlerzeichenfolgen oder kategoriale Auswahlen mit starren Routing-Tabellen ab.
- Sprachmodelle verarbeiten unstrukturierte Texttranskripte ausschließlich, um Zusammenfassungen und Taxonomievorschläge zu extrahieren.
Prinzipien für die zielgerichtete Abgrenzung eines MVP ohne Verschwendung beim Aufbau erster Routing-Prototypen. Zielgerichtete Abgrenzung eines MVP ohne Verschwendung.
Ausnahmen und Verlauf prüfen
Nutzen Sie separate Ausnahmepfade für nicht klassifizierte Anfragen, nicht verfügbare Integrationen sowie ungültige oder verdächtige Ereignisse. Leiten Sie Payloads mit fehlgeschlagener Signaturprüfung nicht unter Beibehaltung aller Inhalte in eine reguläre Bearbeiter-Warteschlange: Weisen Sie diese gemäß der vereinbarten Sicherheitsrichtlinie ab oder isolieren Sie sie in Quarantäne. Weisen Sie legitimen ungelösten Anfragen eine zuständige Person und ein Prüfziel zu. Halten Sie dringende Vorfalls- und Sicherheitsverfahren verfügbar, ohne auf die KI-Verarbeitung zu warten.
Führen Sie einen geschützten Prüfpfad für Ereignisreferenzen, relevante Regel- oder Modellversionen, vorgeschlagene Ziele, Änderungen durch Prüfer und nachgelagerte Bestätigungen. Minimieren Sie personenbezogene Daten, schwärzen Sie Zugangsdaten und definieren Sie Zugriffs- sowie Aufbewahrungsgrenzen, anstatt standardmäßig vollständige Konversationen zu protokollieren. Testen Sie Wiederholungsversuche, Duplikatsvermeidung und den Abgleich nach Teilfehlern. Protokolle unterstützen Untersuchungen; sie garantieren weder ein fehlerfreies Routing noch einen unterbrechungsfreien Betrieb.
Was ein Mensch prüfen muss
Eine Prüfoberfläche kann vorgeschlagene Kategorien neben verifizierten Kontoattributen, Quellreferenzen und fehlenden Informationen anzeigen. Geben Sie der Fachkraft die Befugnis, die Anfrage abzulehnen, neu zuzuweisen oder zu eskalieren, und machen Sie die ausstehende Warteschlange für eine verantwortliche Person sichtbar. Die Überprüfung ist eine Kontrollmaßnahme, die getestet werden muss, kein Beweis für die Richtigkeit eines KI-Vorschlags.
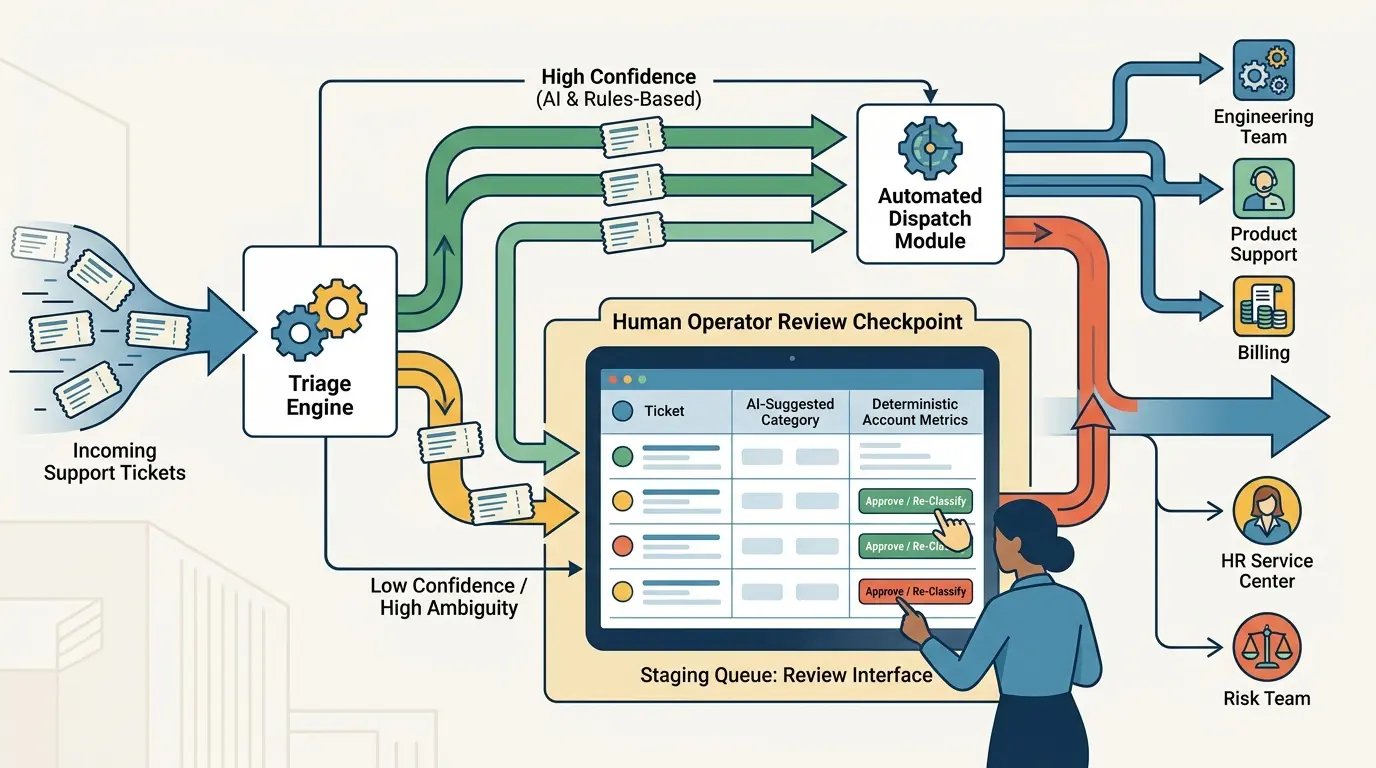
Die Fachkraft prüft die Quellennachweise, das Ziel und die Priorität, bevor sie die vorgeschlagene Aktualisierung genehmigt. Die Oberfläche sollte anzeigen, ob das Empfangssystem sie akzeptiert hat, doppelte Übermittlungen verhindern und fehlgeschlagene Übertragungen wiederherstellbar halten. Behalten Sie eine autorisierte manuelle Route bei, falls die Integration nicht verfügbar ist. Messen Sie Korrekturraten und Prüfzeiten während des Pilotprojekts, bevor Sie den automatischen Versand ausweiten.
Die erste Umsetzung eingrenzen
Vergleichen Sie die vorhandenen Helpdesk-Einstellungen, unterstützte Konnektoren und eine kleine individuelle Erweiterung anhand derselben repräsentativen Fälle. Berücksichtigen Sie Einführung, Zugriffsverwaltung, Überwachung, Ausnahmebehandlung und die Verantwortung für den laufenden Betrieb. Individuelle Entwicklung braucht eine konkrete ungedeckte Anforderung; steigendes Ticketvolumen oder mehrere Werkzeuge allein reichen als Begründung nicht aus.
Um einen ersten Automatisierungsumfang zu besprechen, beschreiben Sie die Eingangskanäle, Empfängerteams, Werkzeuge, das ungefähre wöchentliche Volumen und das wiederkehrende Routing-Problem. Teilen Sie anonymisierte Beispiele ohne Kundenkonversationen, Zugangsdaten oder private Kontodaten. Wir können die Konfiguration mit einer kleinen Integration vergleichen, die ersten unterstützten Fälle, Prüf- und Wiederherstellungsregeln, Abnahmetests sowie die Übergabedokumentation vereinbaren. Die zitierten Stellenausschreibungen belegen weder Kundenprojekte von YAS noch gemessene Einsparungen oder die intern von diesen Unternehmen genutzten Systeme.
Analyse der technischen Kompromisse und der Kosten für die Workflow-Automatisierung über interne operative Werkzeuge hinweg. Kosten der Workflow-Automatisierung.
| Unternehmen | Rolle | Ausgeschriebene Aufgabe | Was sich daraus ableiten lässt | Quellenzugriffsdatum |
|---|---|---|---|---|
| Stripe | Support Operations, Privy | Own triage and routing for inbound support tickets from both Privy developers and end users of Privy applications, ensuring issues are assigned, tracked, and resolved promptly and efficiently across the Developer Success team. | Die Anzeige weist die Verantwortung für die Verwaltung von Eingangs-Warteschlangen und die Weiterleitung von Tickets über Entwickler- und Endbenutzergruppen hinweg zu. | 2026-08-27 |
| Gusto | Relationship Manager, CX | Triage, troubleshoot, and escalate technical bugs with clear documentation so our Engineering team can act quickly. | Die Anzeige beschreibt die Bewertung von Kunden-Fehlerberichten, das Erstellen von Dokumentationen und die Eskalation von Fällen an die Entwicklung. | 2026-08-20 |
| Gusto | People Process Transformation Lead | Lead the HR Service Center responsible for Tier 0/1 Gustie (employee) and People Empowerer (manager) support. | Die Anzeige umreißt die Leitung eines operativen Hubs, der Anfragen von Frontline-Mitarbeitern und Führungskräften bearbeitet. | 2026-08-24 |
| Ramp | Customer Experience Associate | When an issue crosses team boundaries — risk, engineering, product, partnerships — you route it correctly, follow up, and make sure the customer isn't left waiting. You'll work across Zendesk, internal tooling, and Slack-based escalation workflows. | Die Anzeige beschreibt das bereichsübergreifende Ticket-Routing und die Nachverfolgung über Ticket- und Chat-Systeme hinweg. | 2026-08-26 |
Checkliste für die Weiterleitung
- Bestehende Support- und Eingangskanäle prüfen, um alle Einstiegspunkte für Kundenanfragen und interne Anliegen zu dokumentieren.
- Die Verteilung eingehender Anfragen nach Kategorie, Mandantenstufe und erforderlichem nachgelagertem Ziel messen.
- Den Anteil der Tickets berechnen, die nach dem ersten Eingang eine manuelle Neuzuweisung oder Feldkorrektur erfordern.
- Deterministische Routing-Regeln identifizieren, die rein auf strukturierten Metadaten ohne semantische Interpretation ausgeführt werden können.
- Klassifizierungsfehler anhand repräsentativer, autorisierter Beispiele bewerten; Prüfschwellen nach Risiko vereinbaren, anstatt einen modellgenerierten Konfidenzwert als Wahrscheinlichkeit für Richtigkeit zu betrachten.
- Erforderliche Integrationsverträge zwischen primären Helpdesk-Plattformen, Entwicklungs-Trackern und internen Datenbanken abbilden.
- Zuständigkeiten und Warnmeldungen für ungelöste berechtigte Anfragen zuweisen, Routen für dringende Reaktionen beibehalten und eine separate Ablehnungs- oder Quarantänerichtlinie für fehlerhafte oder nicht vertrauenswürdige Ereignisse definieren.
- Testen Sie eine begrenzte Prüfwarteschlange mit einem erprobten manuellen Ersatzablauf, Duplikatschutz und Fehlerbehebung bei fehlgeschlagener Zustellung, bevor Sie automatische Weiterleitung für freigegebene Fälle erlauben.
Explizite Routing-Regeln, verifizierter Kontext und eine nachvollziehbare Ausnahmebehandlung sollten den Workflow definieren; KI-generierte Vorschläge ersetzen diese Kontrollen nicht.
Häufige Fragen
Beweisen diese Stellenanzeigen, dass den einstellenden Unternehmen eine interne Triage-Automatisierung fehlt?
Nein. Die Stellenanzeigen belegen lediglich, dass menschlichen Bearbeitern spezifische Triage-, Routing- und Eskalationsaufgaben zugewiesen sind. Sie dokumentieren weder das Vorhandensein noch das Fehlen oder den Reifegrad interner Software-Tools, die derzeit von diesen Teams eingesetzt werden.
Warum sollte deterministisches Filtern der KI-Klassifizierung in Routing-Software vorausgehen?
Explizite Regeln können bekannte Prioritäts- und Routing-Richtlinien anwenden, ohne dass ein Modell diese ableiten muss. Sie hängen weiterhin von einer korrekten Konfiguration, aktuellen Eingaben und autorisierten Account-Zuordnungen ab. Testen Sie widersprüchliche oder fehlende Felder und machen Sie Ausnahmen sichtbar; eine rein deterministische Verarbeitung garantiert weder Compliance noch ein korrektes Ziel.
Wann sollte eine Organisation eine eigene Routing-Engine entwickeln, anstatt Helpdesk-Einstellungen zu konfigurieren?
Testen Sie zunächst die unterstützten Helpdesk-Einstellungen und Konnektoren anhand repräsentativer Fälle. Ziehen Sie eine begrenzte individuelle Erweiterung in Betracht, wenn eine spezifische Anforderung unerfüllt bleibt und ein zuständiges Team Zugriffskontrollen, Wartung, Überwachung und Fehlerbehebung übernehmen kann. Komplexe Integrationen oder ein hohes Volumen allein beweisen nicht, dass Individualsoftware günstiger oder zuverlässiger sein wird.
Welche Rolle behält ein menschlicher Bearbeiter in einer automatisierten Triage-Architektur?
Ein Prüfer prüft die Belege, korrigiert oder lehnt vorgeschlagene Zuweisungen ab und bearbeitet Ausnahmen gemäß der vereinbarten Richtlinie. Die Benutzeroberfläche muss Unsicherheiten offenlegen und eine Eskalation ermöglichen. Prüfqualität, Arbeitsbelastung und übersehene dringende Fälle müssen gemessen werden; ein menschlicher Genehmigungsschritt ist keine Garantie für betriebliche Präzision.
Wie können Entwicklungsteams die Baseline-Triage-Leistung messen, bevor sie Software entwickeln?
Nutzen Sie autorisierte Stichproben, um Neuzuweisungen, die Zeit bis zur richtigen Warteschlange, fehlenden Kontext und Korrekturen durch Prüfer zu messen. Trennen Sie technische Übertragungsfehler von unklaren Zuständigkeiten oder Kapazitätsgrenzen. Vergleichen Sie das Pilotprojekt mit dieser Baseline und erfassen Sie dabei Duplikate, unbehandelte Ausnahmen sowie dringende Fälle, ohne unnötige Kundendaten zu exportieren.