Начните с частой, четко определенной задачи, результат которой можно проверить, а возможные сбои — локализовать. Кандидатами могут быть сортировка обращений в техподдержку, подготовка полей документов для проверки и рутинная передача данных между системами. Выбирайте, опираясь на реальный объем, долю исключений, доступные интеграции и наличие ответственного владельца процесса. Не каждому кандидату нужен ИИ, а первое внедрение должно показать свою ценность до масштабирования.
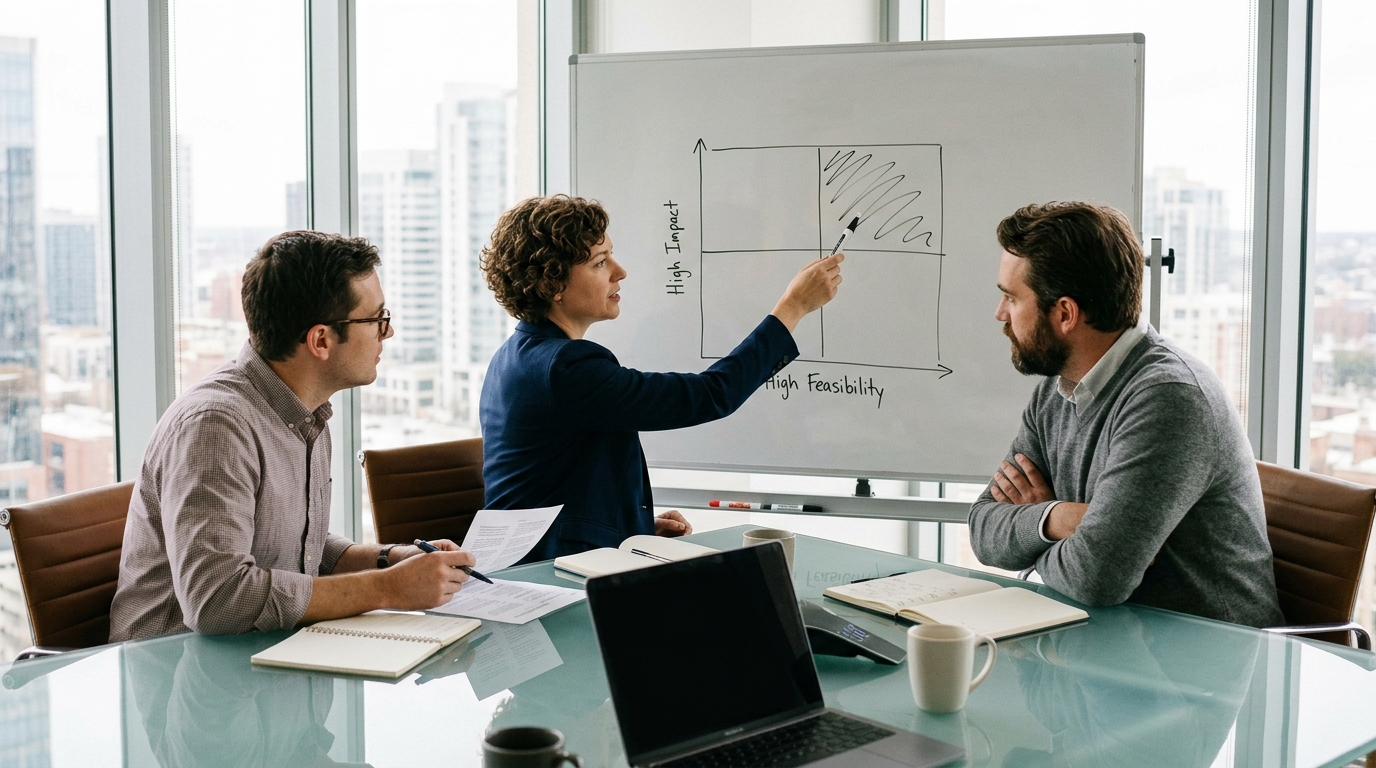
Как выбрать первый процесс для автоматизации
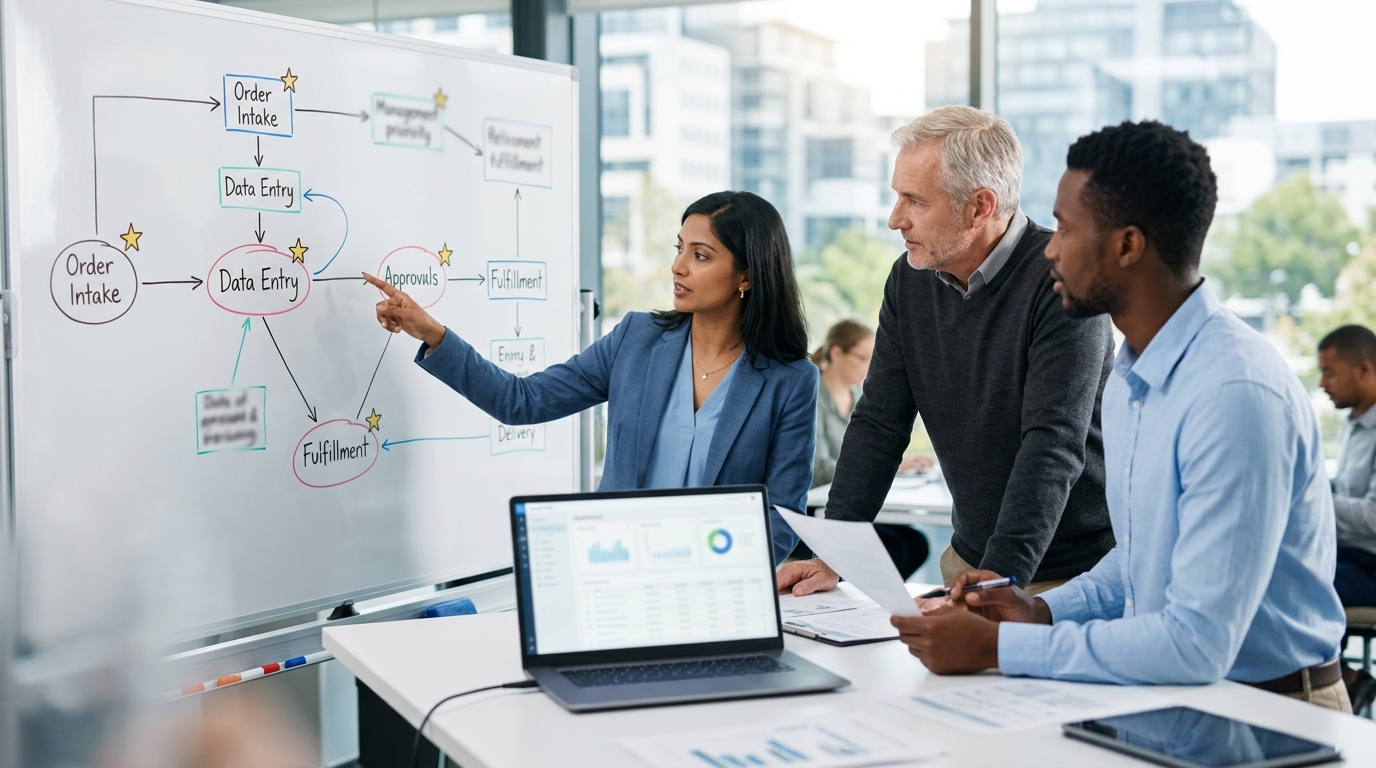
Начните с одного рабочего процесса с повторяемыми входными данными, понятным владельцем и проверяемым результатом. Большой объем полезен, но этого недостаточно: частая ошибка, меняющая баланс клиента, — это совсем другая отправная точка, нежели подготовка внутреннего черновика. Я бы сравнивал кандидатов на одном и том же недавнем периоде и учитывал время, затраченное на исправление исключений, а не только на стандартный сценарий.
Для каждого кандидата зафиксируйте событие, запускающее процесс, задействованные системы, ручное действие и приемлемый результат. Затем ответьте на четыре вопроса. Может ли сотрудник объяснить правила? Доступны ли характерные примеры входных данных? Можно ли проверить результат до совершения важного действия? Может ли человек остановить обработку и разобраться со сбоем? Если ответа хотя бы на один вопрос нет, первым результатом может стать уточнение процесса или улучшение данных, а не интеграция ИИ.
- Ценность: Как часто это происходит, сколько времени занимает и чему мешает задержка? Зафиксируйте базовые показатели вместо предположений о процентной экономии.
- Реализуемость: Могут ли существующие инструменты предоставить необходимые данные и права доступа? Проверьте встроенную функцию или готовый коннектор, прежде чем заказывать разработку.
- Риск: Что произойдет, если результат окажется неверным, продублированным или запоздалым? Подготовка данных и их проверка — обычно более ограниченный первый этап, чем самостоятельное выполнение действий во внешних системах.
- Ответственность за процесс: Кто проверяет исключения, оплачивает регулярные расходы и поддерживает процесс при изменении API или бизнес-правил?
Эти критерии — не универсальная оценка для прогнозирования ROI. Сравните сильнейших кандидатов на реальных примерах записей. Выберите ограниченный первый этап с понятными критериями приемки; отложите кандидата с неясными входными данными или несоразмерными затратами на восстановление. Детерминированное правило или интеграция по расписанию могут решить проблему без ИИ. Используйте модель там, где действительно требуется интерпретация текста или документов, и оценивайте этот шаг отдельно.
Сортировка и маршрутизация обращений в поддержку
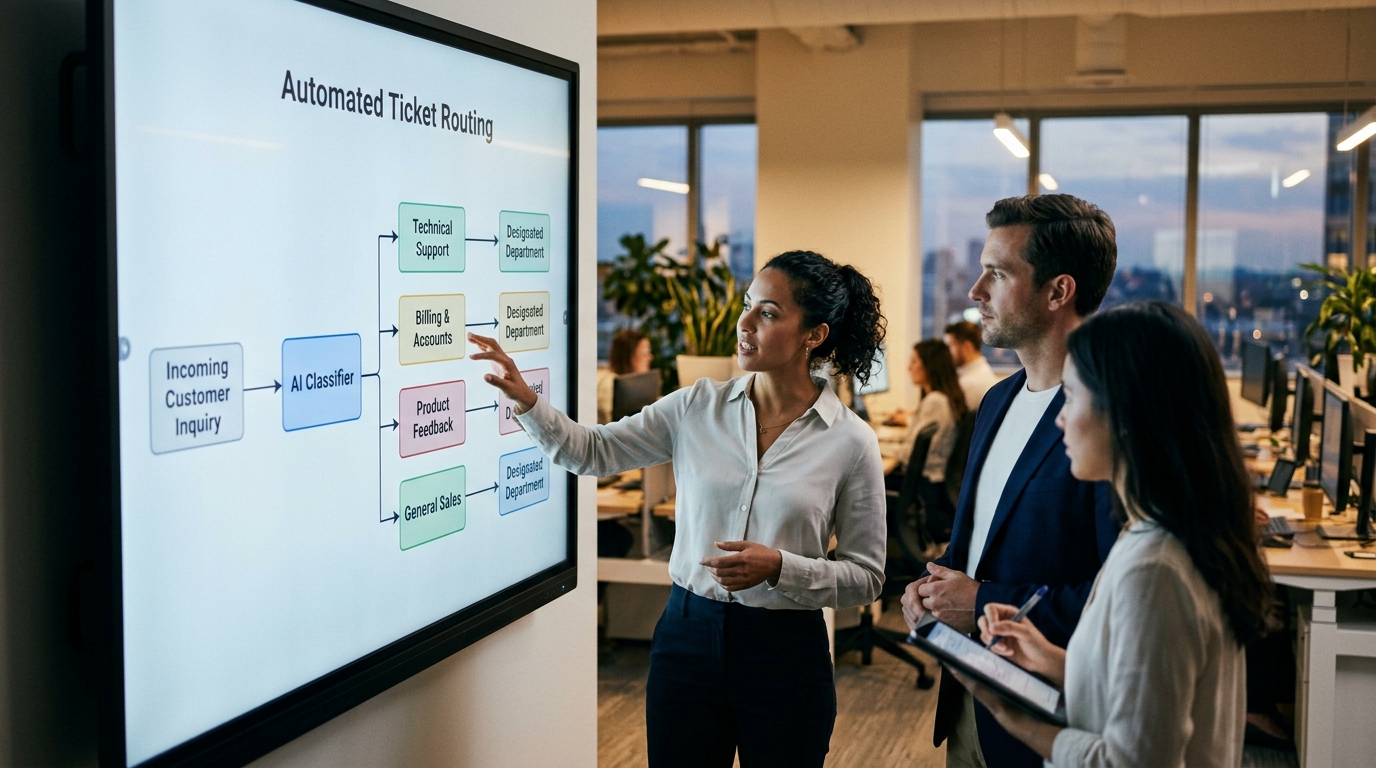
К сортировке обращений стоит присмотреться, когда сотрудники постоянно читают входящие сообщения, определяют одни и те же типы запросов и перенаправляют их между очередями. Измерьте время на сортировку и исправление ошибок маршрутизации. Начните с определенного набора категорий и очереди для исключений, а не с предположения, что каждое сообщение можно классифицировать безошибочно.
Внедрение системы автоматической классификации может помочь устранить эти операционные узкие места. Используя обработку естественного языка и классификаторы машинного обучения, компании могут анализировать текстовое содержание входящих тикетов поддержки в реальном времени. Система оценивает сообщение, чтобы определить вероятное намерение, категорию и срочность запроса. После классификации тикет может автоматически размечаться тегами и направляться в нужный отдел или очередь оператора на основе заранее заданных правил маршрутизации. Такая автоматическая маршрутизация снижает потребность в ручной сортировке и сводит к минимуму внутренние пересылки тикетов.
Однако такие системы нужно проектировать с четкими границами и резервными сценариями. Простые повторяющиеся запросы — например, запрос трек-номера или инструкции по сбросу пароля — могут подходить для автоматических ответов, тогда как более сложные или эмоционально чувствительные обращения следует сразу передавать сотруднику. Автоматизированная система не заменяет понимание ситуации и эмпатию, необходимые для разрешения сложных жалоб. Поэтому основная цель автоматизации сортировки — упростить путь к помощи человека, предоставляя сотрудникам структурированную и предварительно классифицированную информацию.
Синхронизация складских запасов и заказов в e-commerce
Для омниканальных e-commerce брендов поддержание точных остатков на различных торговых площадках, складах и в розничных точках остается постоянной операционной проблемой. Когда обновления запасов выполняются вручную или через медленные пакетные выгрузки файлов, риск расхождения данных существенно возрастает. Задержка в обновлении остатков может привести к оверселлингу, когда клиенты покупают товары, которых уже нет в наличии, что ведет к отмене заказов, административным издержкам и недовольству покупателей. И наоборот, занижение остатков во избежание оверселлинга может обернуться упущенными продажами и неэффективным распределением капитала.
Автоматизация синхронизации запасов и заказов предполагает создание прямых каналов связи в реальном времени между торговыми платформами и системами управления складом (WMS) через API. При совершении транзакции на одном канале система автоматизации сразу фиксирует детали заказа, обновляет центральную базу данных запасов и передает скорректированные остатки на все остальные подключенные платформы. Этот непрерывный цикл помогает отображать клиентам максимально точные данные об остатках, снижая операционные сложности, связанные с ручными сверками и корректировками склада.
Несмотря на очевидные преимущества автоматической синхронизации, операторы должны понимать, что технологии сами по себе не могут устранить физические расхождения в цепочке поставок. Если на складе ошиблись при подсчете физических остатков, автоматизированная система просто синхронизирует неверные данные по всем каналам. Кроме того, лимиты запросов к API, сетевые задержки и временные сбои систем могут нарушить поток обновлений. Поэтому надежная архитектура синхронизации должна включать протоколы обработки ошибок, проверки валидности данных и регулярные автоматические процедуры сверки для выявления и фиксации расхождений между физическими записями склада и цифровыми торговыми площадками.
Извлечение данных и обработка документов
Многие ключевые бизнес-процессы по-прежнему зависят от неструктурированных данных в физических или цифровых документах, таких как счета-фактуры, заказы на поставку, транспортные накладные и чеки. Исторически извлечение этой информации и ее ввод во внутренние базы данных или ERP-системы требовали ручной перепечатки. Этот ручной ввод данных медленный, затратный и подвержен человеческим ошибкам, таким как опечатки или неверно поставленные запятые в числах. По мере роста объемов транзакций ручная обработка документов часто становится узким местом, задерживая последующие процессы, такие как расчеты с поставщиками или выполнение заказов.
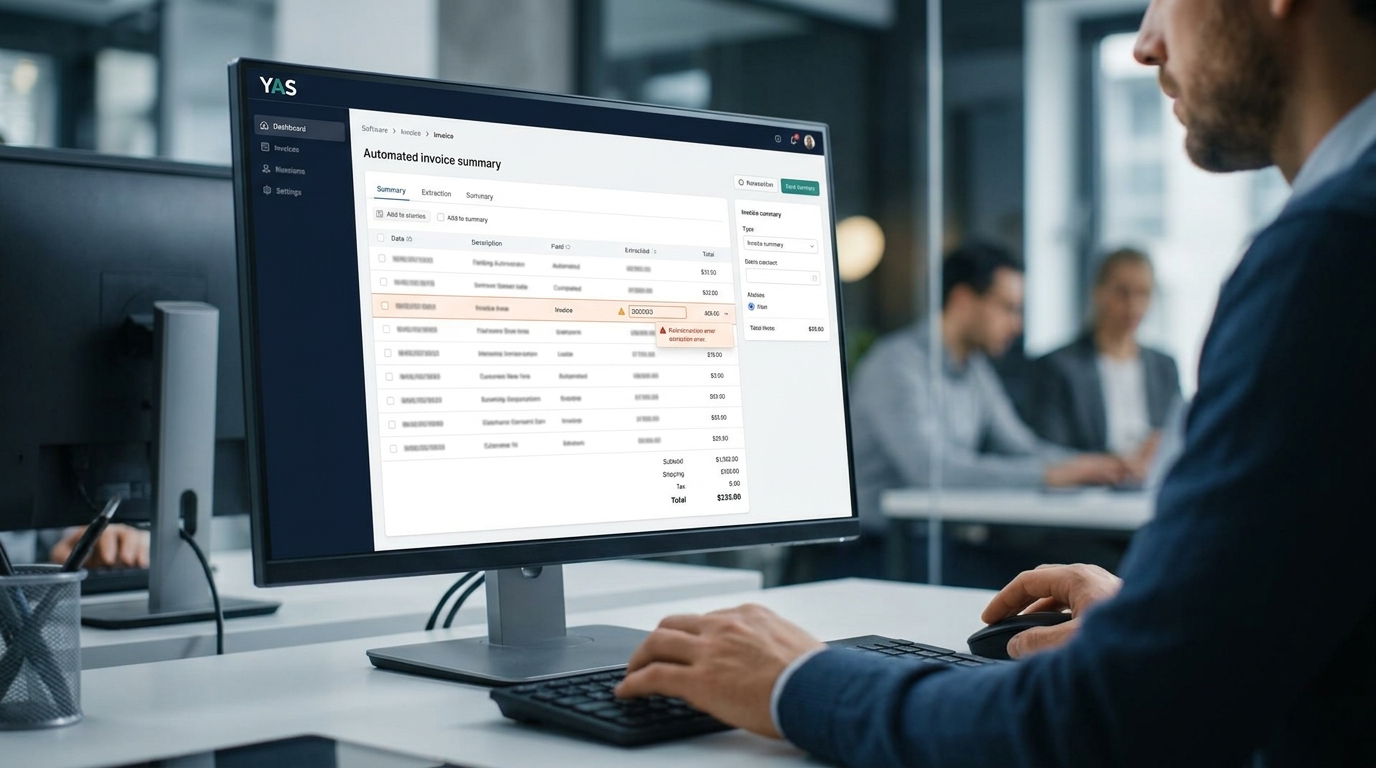
Современная автоматизация обработки документов решает эту проблему за счет объединения оптического распознавания символов (OCR) с языковыми моделями для извлечения структурированных данных из неструктурированных файлов. При поступлении документа — будь то вложение в email или загрузка в облачную папку — автоматизированный конвейер принимает файл, разбирает текст и определяет ключевые поля на основе контекста. Например, в процессе работы со счетами поставщиков система может найти и извлечь название поставщика, номер счета, позиции, суммы налогов и итоговую сумму к оплате. Затем эти извлеченные данные форматируются в структурированную схему, такую как JSON или CSV, для прямой передачи в бухгалтерское ПО.
Хотя такие автоматизированные системы извлечения обрабатывают документы намного быстрее людей, они не застрахованы от ошибок. Различия в структуре документов, низкое разрешение сканов и рукописный текст могут приводить к неточностям. Чтобы управлять этим риском, компаниям следует внедрять модель проверки с участием человека (human-in-the-loop). В такой модели автоматизированная система обрабатывает документы и присваивает извлеченным данным оценку уверенности. Сама по себе оценка уверенности модели не должна санкционировать транзакцию. Применяйте явные проверки обязательных полей, ссылок на первоисточники, итоговых сумм, дубликатов и нарушений регламентов, а сомнительные результаты отправляйте на проверку человеку. Проверку человеком также необходимо оценивать: правдоподобное, но неверное значение легко пропустить. Извлечение данных может подготовить запись, не имея прав на ее утверждение или оплату.
Автоматизированная сверка финансовых данных
Финансовая сверка — это важнейшая контрольная функция, обеспечивающая точность и полноту финансовых записей организации. Процесс включает сравнение данных транзакций из платежных шлюзов, эквайринговых систем и банковских выписок с внутренними учетными книгами для выявления расхождений. Поскольку эта задача требует сопоставления больших объемов данных из нескольких независимых источников, она часто бывает крайне повторяющейся и трудоемкой для финансовых отделов, особенно во время закрытия месяца. Ручное сопоставление ID транзакций, дат и сумм не только утомительно, но и чревато пропусками, что может приводить к задержкам финансовой отчетности.
Ограниченная задача сопоставления может стать кандидатом на автоматизацию, если исходные записи и правила сопоставления стабильны; однако финансовая сверка не обязательно является лучшим первым процессом для внедрения. Автоматизированные системы сверки можно настроить на получение выписок напрямую из финансовых учреждений и платежных провайдеров через защищенные API или автоматическую передачу файлов. После загрузки данных система применяет заданные правила сопоставления для связывания транзакций из разных наборов данных. Например, выплата по эквайрингу может автоматически сопоставляться с соответствующим банковским депозитом и внутренним заказом на основе уникального номера транзакции и совпадения сумм нетто.
Однако успех автоматизированной сверки сильно зависит от согласованности и качества входящих данных. Разрозненные форматы транзакций, разница курсов валют и временные задержки могут мешать системе находить точные совпадения. Для решения этих проблем архитектура автоматизации должна быть спроектирована так, чтобы корректно обрабатывать исключения. Вместо попыток принудительно связать записи или внести произвольные корректировки система должна применять только утвержденные правила сопоставления и собирать все несопоставленные позиции в отчет об исключениях для ручной проверки финансовым отделом. Это меняет роль финансистов с ручного сведения данных на точечный анализ исключений, усиливая контроль и сокращая время на закрытие периода.
Ограничения и применимость
Не начинайте с размытого указания автоматизировать всю компанию. Если несколько команд расходятся во мнении о том, как выглядит корректный результат, устраните эти разногласия до включения записи данных. Процесс можно улучшать поэтапно: документирование исключений, стандартизация одного источника входных данных или организация очереди на проверку могут принести пользу, даже если весь процесс еще не готов к полной автоматизации.
Оставляйте ответственные решения за конкретным человеком. Система может подготавливать данные для платежа, возврата или сложного клиентского случая, не имея прав на выполнение самого действия. Задавайте эти границы на уровне реализации, а не только в промпте. Ограничьте доступ только необходимыми системами и данными и определите срок хранения диагностических логов.
Перед запуском проверьте корректные входные данные, отсутствующее поле, противоречивые исходные значения, дубликат, таймаут и запись, которую человек изменил в целевой системе. Ожидаемым результатом может быть приостановка обработки записи, а не успешное обновление. Учитывайте нагрузку на проверку и неразобранные исключения: более быстрая генерация не дает преимущества, если другая команда тратит больше времени на исправление результата.
Как YAS оценивает и внедряет автоматизацию
Я начинаю с повторяющейся задачи, инструментов вашей команды и нужного вам результата. Не нужно выбирать модель ИИ или приходить с готовым техзаданием. Для первого разговора достаточно описать, что запускает процесс, где данные передают вручную, каков примерный объем работы и кто разбирает исключения. Не отправляйте пароли, клиентские данные или неограниченный доступ к рабочим системам в первой заявке.
Для реализации под ключ согласованный объем работ должен охватывать карту процессов, интеграции, правила валидации и утверждения, приемочные тесты, внедрение, мониторинг и передачу проекта. Он также должен определять исключения из объема, сторонние расходы и формат поддержки после запуска. Первый рабочий сценарий тестируется на репрезентативных примерах до его масштабирования на другие команды или сценарии. Использование готового коннектора или заказного компонента зависит от реальных требований, а не от симпатии к конкретному инструменту.
Сравните время обработки, долю исправлений, объем накопившихся исключений и постоянные операционные расходы с базовыми показателями ручного труда. Не выдавайте демонстрацию за доказанную экономию. Если предложенная автоматизация требует больше проверок или обслуживания, чем устраняет, сузьте границы, выберите более простое решение или остановитесь. Цель — полезные изменения в работе, а не ИИ-функция ради самой функции.
Изучите публичные примеры автоматизации YAS , чтобы увидеть разницу между работающими процессами в продуктах и предлагаемыми внедрениями. Когда будете готовы обсудить собственный процесс, перейдите к разделу «Внедрение AI-автоматизации». Следующее решение — что именно можно реализовать и проверить в рамках первого этапа, а не обязательство автоматизировать вообще всё.
| Название процесса | Категория сложности | Ключевые входные данные | Уровень операционного риска | Основной метод интеграции |
|---|---|---|---|---|
| Сортировка обращений в поддержку | Зависит от объема работ | Текст входящих писем и тикетов | Зависит от прав на маршрутизацию и ответы | Классификация текста на базе API |
| Синхронизация запасов | Средняя | Остатки на складе и транзакции продаж | Средний | Мультиканальная синхронизация на базе API |
| Извлечение данных из счетов | Средняя | Неструктурированные файлы документов | Выше, если разрешено проведение или оплата | Парсинг с помощью OCR и языковых моделей |
| Финансовая сверка | Высокая | Банковские выписки и файлы учета | Высокий | Специальные правила сопоставления и API ERP-системы |
| Классификация лидов | Низкая | Заявки из форм и контактные данные | Зависит от последующих действий | Правила маршрутизации на базе API |
Шаги для аудита и запуска вашей первой автоматизации
- Пошагово задокументируйте выбранный процесс, чтобы определить все точки принятия решений.
- Определите исходные показатели и типичные ошибки ручного процесса.
- Сформулируйте четкие операционные цели и внутренние параметры для автоматизации.
- Соберите первую рабочую версию автоматизации с помощью API или инструментов управления процессами.
- Запустите автоматизацию в контролируемой тестовой среде с валидацией человеком (human-in-the-loop).
- Постепенно разворачивайте решение в рабочей среде и внимательно отслеживайте пограничные случаи.
Автоматизация заключается не в замене человеческих решений, а в освобождении команды от рутинных задач, чтобы сотрудники могли сосредоточиться на ценном и творческом решении проблем.
Часто задаваемые вопросы
Как понять, что процесс готов к автоматизации?
Процесс готов к автоматизации, если он часто повторяется, основан на четких правилах и использует структурированные цифровые данные. Если ваша команда может составить понятную пошаговую инструкцию по выполнению задачи без опоры на субъективные суждения, это сильный кандидат.
Каковы риски слишком быстрой автоматизации?
Слишком быстрая автоматизация без должного тестирования может привести к системным сбоям, повреждению данных и негативному клиентскому опыту. Если исходный процесс не отлажен, автоматизация лишь ускорит появление ошибок.
Стоит ли использовать готовые инструменты или разрабатывать заказные решения?
Сопоставьте готовые инструменты с требованиями к данным, правам доступа, пропускной способности, обработке исключений и поддержке. Используйте заказную разработку для специфических неподдерживаемых требований. Ни один из подходов не является автоматически более надежным или дешевым; сравнивайте полную стоимость владения и проверяйте поведение при сбоях.
Чем ИИ-автоматизация отличается от традиционной RPA?
Автоматизация на основе правил следует заданным условиям; ИИ помогает интерпретировать текст или предлагать поля из документов. Эти подходы можно совмещать. Ни шаг с ИИ, ни автоматизация через интерфейс не защищены от изменений UI, отсутствия данных или неверных результатов. Выбирайте простейший подход, соответствующий критериям приемки.
Каковы типичные сроки окупаемости инвестиций (ROI) в автоматизацию?
Сроки проявления операционных улучшений сильно варьируются и зависят от сложности процесса, объема транзакций и точности первоначальной настройки. Поскольку у каждого бизнеса уникальные требования к интеграции, гарантированных сроков окупаемости инвестиций не существует.
Как работать с опасениями сотрудников по поводу автоматизации?
Позиционируйте автоматизацию как инструмент, берущий на себя рутинные административные задачи, позволяя сотрудникам сосредоточиться на более интересных и значимых проектах. Вовлечение команды в процесс проектирования помогает им наглядно увидеть пользу для своей ежедневной работы.
Сценарии выбора
Иллюстративные сценарии применения подхода, а не выполненные клиентские проекты или измеренные результаты.
Сценарий 1: Сортировка обращений: начните с определённого набора категорий и очереди на проверку. Оцените ошибки маршрутизации до её автоматического включения; не включайте самостоятельные ответы в первый этап по умолчанию.
Сценарий 2: Подготовка контент-брифа: если команда не согласовала категории или критерии приёмки, сначала уточните их. Черновик, требующий значительной переработки, может лишь переносить работу на следующий этап.
Сценарий 3: Подготовка каталога: предлагайте изменения атрибутов со ссылками на источники и назначенным проверяющим. Цены, остатки и публикация не входят в первый этап, если их отдельно не согласовали и не протестировали.