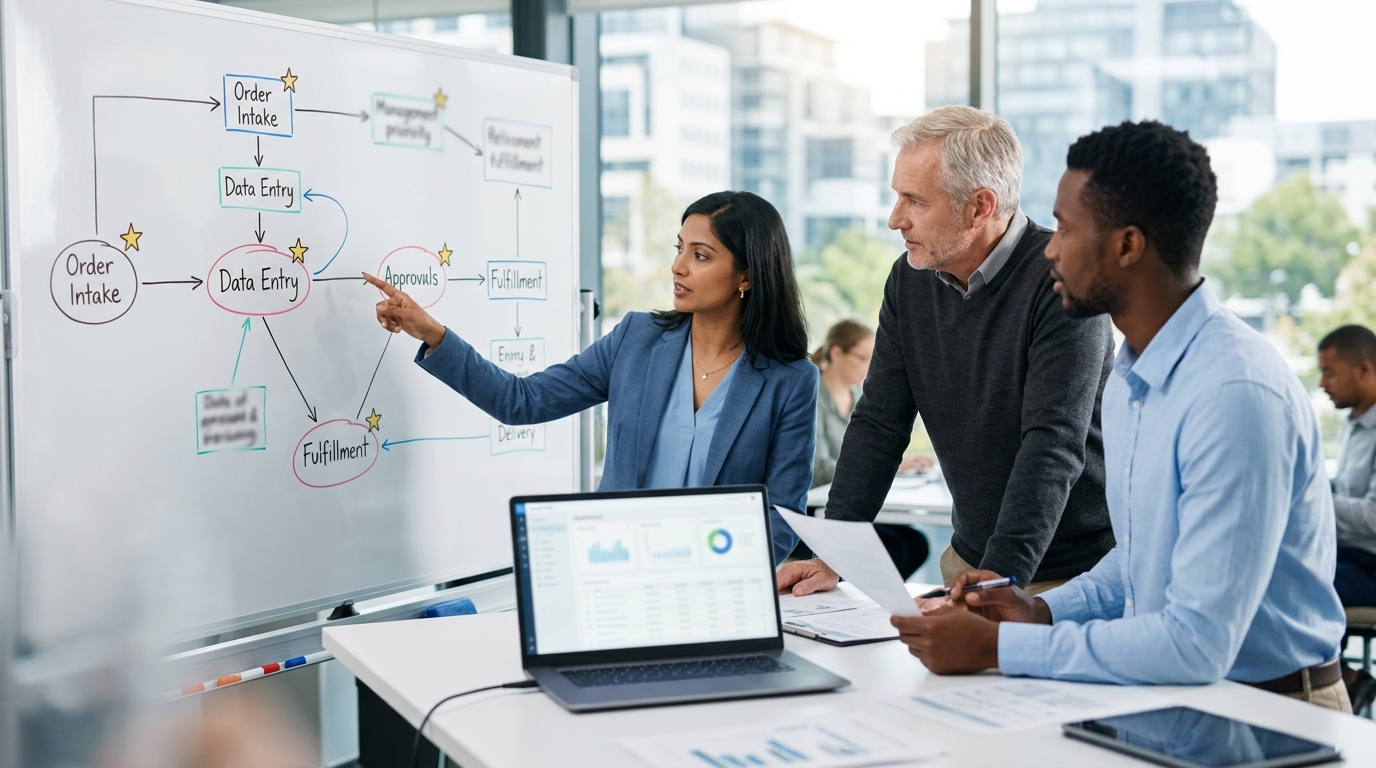
Beginnen Sie mit einer häufigen, klar definierten Aufgabe, deren Ergebnis überprüft werden kann und deren Fehler sich begrenzen lassen. Die Sortierung von Support-Tickets, die Vorbereitung von Dokumentfeldern zur Prüfung und Routineübertragungen zwischen Systemen können geeignete Kandidaten sein. Treffen Sie die Auswahl anhand Ihres tatsächlichen Volumens, der Ausnahmerate, der verfügbaren Integrationen und eines verantwortlichen Prozesseigentümers. Nicht jeder Kandidat erfordert KI, und eine erste Implementierung sollte ihren Wert vor einem breiteren Rollout belegen.
So wählen Sie den ersten Prozess aus
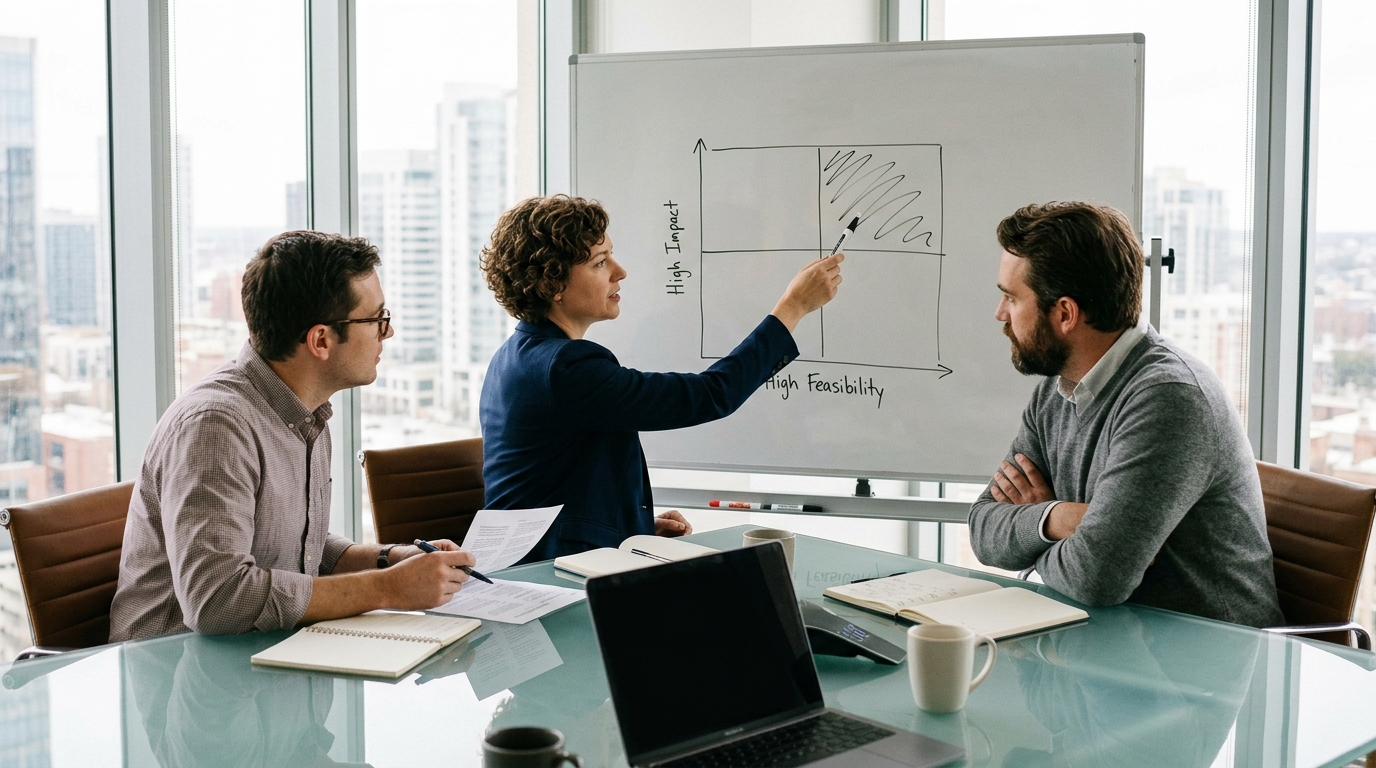
Beginnen Sie mit einem einzelnen Workflow, der wiederholbare Eingaben, einen klaren Verantwortlichen und ein prüfbares Ergebnis aufweist. Ein hohes Volumen hilft, reicht aber nicht aus: Ein wiederkehrender Fehler, der Kundensalden verändert, ist ein anderer Ausgangspunkt als das Erstellen eines internen Entwurfs. Ich würde Kandidaten anhand desselben aktuellen Zeitraums vergleichen und die für die Korrektur von Ausnahmen aufgewendete Zeit einbeziehen, nicht nur die Zeit für den regulären Ablauf.
Notieren Sie für jeden Kandidaten den Auslöser, die beteiligten Systeme, die manuelle Handlung und das akzeptable Ergebnis. Beantworten Sie dann vier Fragen: Kann ein Sachbearbeiter die Regeln erklären? Liegen repräsentative Eingabedaten vor? Lässt sich das Ergebnis vor einer wichtigen Aktion überprüfen? Kann jemand die Verarbeitung anhalten und einen fehlerhaften Durchlauf beheben? Wenn eine Antwort fehlt, besteht das erste Ergebnis möglicherweise in einem klareren Prozess oder besseren Daten statt in einer KI-Integration.
- Wert: Wie oft kommt dies vor, wie lange dauert es und was wird durch eine Verzögerung verhindert? Erfassen Sie einen Ausgangswert, anstatt prozentuale Einsparungen anzunehmen.
- Machbarkeit: Können die bestehenden Tools die erforderlichen Daten und Berechtigungen bereitstellen? Prüfen Sie native Funktionen oder vorhandene Konnektoren, bevor Sie individuellen Code in Auftrag geben.
- Risiko: Was passiert, wenn die Ausgabe falsch, dupliziert oder verspätet ist? Vorbereitung und Überprüfung stellen in der Regel einen enger gefassten ersten Rahmen dar als autonome externe Aktionen.
- Zuständigkeit: Wer prüft Ausnahmen, trägt die laufenden Kosten und pflegt den Workflow, wenn sich eine API oder Geschäftsregel ändert?
Diese Kriterien sind kein universeller Score zur Prognose des ROI. Vergleichen Sie die aussichtsreichsten Kandidaten anhand tatsächlicher Beispieldatensätze. Wählen Sie eine eingegrenzte erste Implementierung mit klaren Akzeptanzkriterien; stellen Sie Kandidaten mit unsicheren Eingaben oder unverhältnismäßigen Wiederherstellungskosten zurück. Eine deterministische Regel oder eine geplante Integration kann das Problem möglicherweise ohne KI lösen. Setzen Sie ein Modell dort ein, wo die Interpretation von Texten oder Dokumenten wirklich erforderlich ist, und bewerten Sie diesen Schritt separat.
Triage und Ticket-Routing im Kundensupport
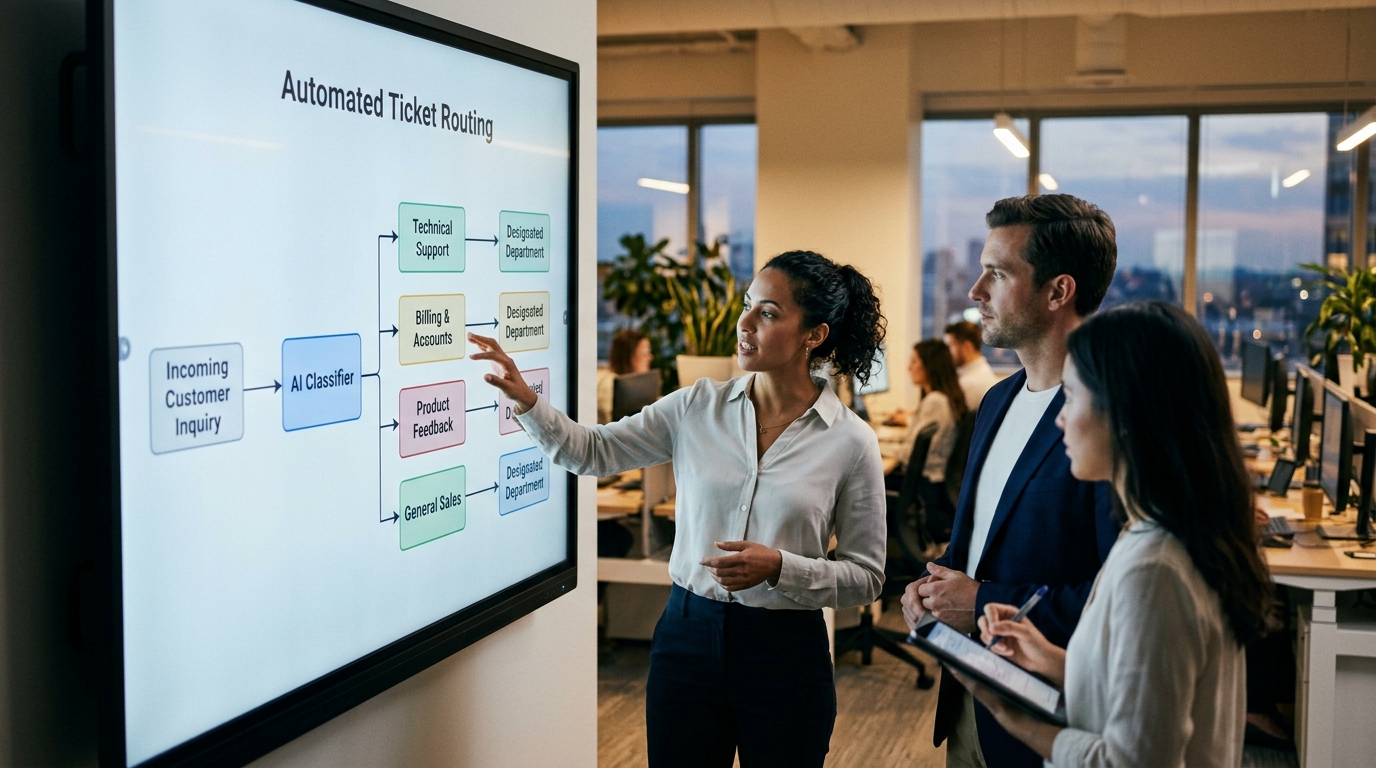
Die Support-Triage lohnt eine nähere Betrachtung, wenn Agenten eingehende Nachrichten wiederholt lesen, dieselben Anfragetypen identifizieren und Tickets zwischen Warteschlangen verschieben. Messen Sie die Zeit, die für das Sortieren und Korrigieren falsch weitergeleiteter Tickets aufgewendet wird. Beginnen Sie mit einem definierten Kategoriensatz und einer Ausnahmewarteschlange, anstatt davon auszugehen, dass jede Nachricht korrekt klassifiziert werden kann.
Die Einführung eines automatisierten Klassifizierungssystems kann dazu beitragen, diese betrieblichen Engpässe zu verringern. Durch den Einsatz von natürlicher Sprachverarbeitung und Machine-Learning-Klassifikatoren können Unternehmen den Textinhalt eingehender Support-Tickets in Echtzeit analysieren. Das System wertet die Nachricht aus, um die wahrscheinliche Absicht, Kategorie und Dringlichkeit der Anfrage zu ermitteln. Nach der Klassifizierung kann das Ticket basierend auf vordefinierten Routing-Regeln automatisch mit Tags versehen und an die zuständige Abteilung oder Agenten-Warteschlange weitergeleitet werden. Dieses automatisierte Routing reduziert den manuellen Sortieraufwand und minimiert interne Ticketweiterleitungen.
Betreiber müssen solche Triage-Systeme jedoch mit klaren Grenzen und Fallback-Mechanismen konzipieren. Während einfache, stark repetitive Anfragen – wie etwa nach Sendungsnummern oder Passwort-Zurücksetzungen – für automatisierte Antworten geeignet sein können, müssen komplexere oder emotional sensible Anliegen unverzüglich an menschliche Agenten eskaliert werden. Ein automatisiertes System kann das differenzierte Verständnis und das Einfühlungsvermögen, die zur Beilegung komplexer Kundenbeschwerden nötig sind, nicht ersetzen. Das Hauptziel der Support-Triage-Automatisierung sollte daher darin bestehen, den Weg zur menschlichen Unterstützung zu optimieren und sicherzustellen, dass den Agenten gut organisierte, vorkategorisierte Informationen vorliegen, damit sie Probleme effizienter lösen können.
Bestands- und Auftragssynchronisierung im E-Commerce
Für Multi-Channel-E-Commerce-Marken ist die Aufrechterhaltung genauer Bestandsmengen über verschiedene Verkaufsplattformen, Lager und stationäre Einzelhandelsstandorte hinweg eine ständige operative Herausforderung. Wenn Bestandsaktualisierungen manuell oder über langsame, stapelverarbeitete Dateiübertragungen erfolgen, steigt das Risiko von Datenabweichungen erheblich. Eine Verzögerung bei der Bestandsaktualisierung kann zu Überverkäufen führen, bei denen Kunden Artikel kaufen, die tatsächlich vergriffen sind – mit der Folge von stornierten Bestellungen, administrativem Mehraufwand und unzufriedenen Kunden. Umgekehrt kann eine zu niedrige Einschätzung der Bestände zur Vermeidung von Überverkäufen zu verpassten Verkaufschancen und einer ineffizienten Kapitalallokation führen.
Die Automatisierung der Bestands- und Auftragssynchronisierung umfasst den Aufbau direkter Echtzeit-Kommunikationskanäle zwischen Verkaufsplattformen und Lagerverwaltungssystemen (WMS) über Anwendungsprogrammierschnittstellen (APIs). Findet auf einem Verkaufskanal eine Transaktion statt, erfasst das Automatisierungssystem umgehend die Bestelldetails, aktualisiert die zentrale Bestandsdatenbank und überträgt die angepassten Bestandsmengen an alle anderen angebundenen Plattformen. Diese kontinuierliche Schleife trägt dazu bei, dass die den Kunden angezeigten Bestandszahlen möglichst genau sind, und verringert den operativen Aufwand für manuelle Bestandsprüfungen und Lagerkorrekturen.
Trotz der klaren Vorteile einer automatisierten Synchronisierung müssen Betreiber erkennen, dass Technologie allein physische Abweichungen in der Lieferkette nicht beheben kann. Wenn in einem Lager physische Bestände falsch gezählt werden, synchronisiert das automatisierte System lediglich die fehlerhaften Daten über alle Kanäle hinweg. Zudem können API-Ratenbegrenzungen, Netzwerklatenzen und vorübergehende Systemausfälle den Fluss der Aktualisierungen stören. Eine robuste Synchronisierungsarchitektur muss daher Fehlerbehandlungsprotokolle, Datenvalidierungsprüfungen und regelmäßige automatisierte Abgleichroutinen umfassen, um Diskrepanzen zwischen physischen Bestandsunterlagen und digitalen Verkaufsplattformen zu erkennen und zu kennzeichnen.
Datenextraktion und Dokumentenverarbeitung
Viele zentrale Geschäftsprozesse hängen nach wie vor von unstrukturierten Daten ab, die in physischen oder digitalen Dokumenten wie Rechnungen, Bestellungen, Frachtbriefen und Belegen enthalten sind. Bisher erforderte die Extraktion dieser Informationen und deren Eingabe in interne Datenbanken oder Enterprise-Resource-Planning-Systeme (ERP) eine manuelle Übertragung. Dieser manuelle Datenerfassungsprozess ist naturgemäß langsam, kostspielig und sehr anfällig für menschliche Fehler wie Tippfehler oder falsch gesetzte Dezimaltrennzeichen. Mit wachsendem Transaktionsvolumen wird die manuelle Dokumentenverarbeitung häufig zu einem betrieblichen Engpass, der nachgelagerte Arbeitsabläufe wie Lieferantenzahlungen oder die Auftragsabwicklung verzögert.
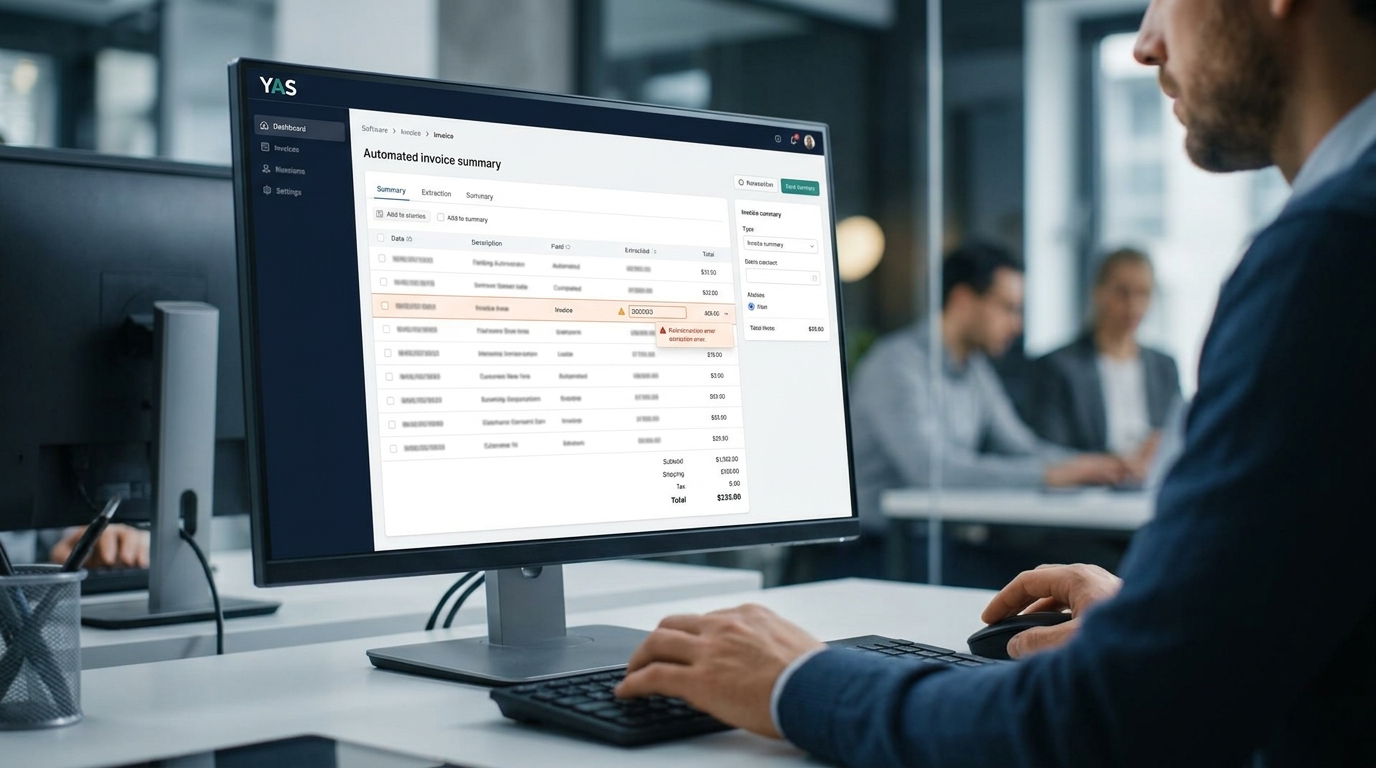
Moderne Lösungen zur automatisierten Dokumentenverarbeitung begegnen dieser Herausforderung, indem sie optische Zeichenerkennung (OCR) mit fortschrittlichen Sprachmodellen kombinieren, um strukturierte Daten aus unstrukturierten Dateien zu extrahieren. Wenn ein Dokument eingeht – sei es als E-Mail-Anhang oder als Upload in ein Cloud-Verzeichnis –, liest die automatisierte Pipeline die Datei ein, analysiert den Text und identifiziert wichtige Datenfelder anhand von Kontextmerkmalen. In einem Workflow der Kreditorenbuchhaltung kann das System beispielsweise den Namen des Lieferanten, die Rechnungsnummer, Einzelpostendetails, Steuerbeträge und den fälligen Gesamtbetrag lokalisieren und extrahieren. Diese extrahierten Daten werden anschließend in ein strukturiertes Schema wie JSON oder CSV formatiert, um direkt in die Buchhaltungssoftware integriert zu werden.
Obwohl diese automatisierten Extraktionssysteme Dokumente wesentlich schneller verarbeiten können als menschliche Bearbeiter, sind sie nicht unfehlbar. Abweichende Dokumentenlayouts, Scans mit geringer Auflösung und handschriftlicher Text können zu Extraktionsfehlern führen. Um dieses Risiko zu steuern, sollten Unternehmen einen „Human-in-the-Loop“-Validierungs-Workflow implementieren. In diesem Modell verarbeitet das automatisierte System die Dokumente und weist den extrahierten Daten einen Konfidenzwert zu. Ein modellgenerierter Konfidenzwert allein sollte eine Transaktion nicht autorisieren. Wenden Sie explizite Prüfungen auf Pflichtfelder, Quellennachweise, Summen, Duplikate und Richtlinienausnahmen an und leiten Sie unsichere Ergebnisse zur Prüfung weiter. Auch die menschliche Überprüfung muss evaluiert werden: Ein plausibler, aber falscher Wert kann übersehen werden. Die Extraktion kann einen Datensatz vorbereiten, ohne die Berechtigung zu haben, ihn zu genehmigen oder zu bezahlen.
Automatisierter Finanzabgleich
Der Finanzabgleich ist eine kritische Kontrollfunktion, die die Genauigkeit und Vollständigkeit der Finanzunterlagen eines Unternehmens sicherstellt. Der Prozess umfasst den Abgleich von Transaktionsdaten aus Payment-Gateways, Zahlungsdienstleistern und Kontoauszügen mit internen Hauptbüchern, um Unstimmigkeiten zu identifizieren. Da diese Aufgabe den Abgleich großer Datenmengen aus mehreren unabhängigen Quellen erfordert, ist sie für Finanzteams oft äußerst repetitiv und zeitaufwendig, insbesondere während des Monatsabschlusses. Der manuelle Abgleich von Transaktions-IDs, Daten und Beträgen ist nicht nur mühsam, sondern auch anfällig für Versehen, was zu verzögerten Finanzberichten führen kann.
Eine abgegrenzte Abgleichsaufgabe kann ein Kandidat sein, wenn die Quelldatensätze und Abgleichsregeln konsistent sind; ein Finanzabgleich ist nicht automatisch die beste erste Automatisierung. Automatisierte Abgleichssysteme können so programmiert werden, dass sie Transaktionsauszüge direkt von Finanzinstituten und Zahlungsabwicklern über sichere APIs oder automatisierte Dateiübertragungen abrufen. Sobald die Daten eingelesen sind, wendet das System vordefinierte Abgleichsregeln an, um Transaktionen über verschiedene Datensätze hinweg zuzuordnen. Beispielsweise kann die Auszahlung einer Kreditkarte von einem Zahlungsdienstleister anhand einer eindeutigen Transaktionsreferenznummer und übereinstimmender Nettobeträge automatisch der entsprechenden Bankeinzahlung und dem internen Kundenauftrag zugeordnet werden.
Der Erfolg des automatisierten Abgleichs hängt jedoch stark von der Konsistenz und Qualität der Eingabedaten ab. Inkonsistente Transaktionsformate, Währungsumrechnungsdifferenzen und zeitliche Verzögerungen können das System daran hindern, exakte Übereinstimmungen zu finden. Um diese Herausforderungen zu bewältigen, muss die Automatisierungsarchitektur so ausgelegt sein, dass sie Ausnahmen sauber handhabt. Anstatt zu versuchen, Übereinstimmungen zu erzwingen oder willkürliche Anpassungen vorzunehmen, sollte das System nur die genehmigten Abgleichsregeln anwenden und alle nicht zugeordneten Posten in einem Ausnahmebericht zur manuellen Prüfung durch das Finanzteam zusammenstellen. Dies verlagert die Rolle von Finanzfachkräften vom manuellen Datenabgleich hin zu einer fokussierten, ausnahmebasierten Analyse, was die Übersicht verbessert und den Zeitaufwand für den Monatsabschluss verringert.
Grenzen und Eignung
Beginnen Sie nicht mit dem uneingeschränkten Auftrag, das gesamte Unternehmen zu automatisieren. Wenn mehrere Teams uneins darüber sind, wie ein korrektes Ergebnis aussieht, klären Sie diese Uneinigkeit, bevor Sie Schreibzugriffe aktivieren. Ein Workflow kann stufenweise verbessert werden: Das Dokumentieren von Ausnahmen, das Standardisieren einer einzelnen Eingabe oder das Vorbereiten einer Prüfwarteschlange kann bereits nützlich sein, selbst wenn der gesamte Prozess noch nicht für eine Automatisierung bereit ist.
Belassen Sie folgenreiche Entscheidungen bei einer verantwortlichen Person. Ein System kann Informationen für eine Zahlung, eine Rückerstattung oder einen sensiblen Kundenfall vorbereiten, ohne autorisiert zu sein, die Aktion auszuführen. Definieren Sie diese Grenze in der Implementierung, nicht nur in einem Prompt. Beschränken Sie den Zugriff auf die erforderlichen Systeme und Daten und legen Sie fest, wie lange Diagnoseprotokolle aufbewahrt werden.
Testen Sie vor dem Start eine gültige Eingabe, ein fehlendes Feld, widersprüchliche Quellwerte, ein Duplikat, ein Timeout und einen Datensatz, den eine Person im Zielsystem geändert hat. Das erwartete Ergebnis kann ein zurückgehaltener Datensatz statt eines erfolgreichen Schreibvorgangs sein. Beziehen Sie den Prüfaufwand und ungelöste Ausnahmen in die Bewertung ein: Eine schnellere Generierung ist kein Vorteil, wenn ein anderes Team länger braucht, um das Ergebnis zu korrigieren.
Wie YAS Automatisierung bewertet und umsetzt
Ich beginne mit der wiederkehrenden Aufgabe, den Tools, die Ihr Team bereits nutzt, und dem Ergebnis, das Sie benötigen. Sie müssen weder ein KI-Modell auswählen noch eine technische Spezifikation mitbringen. Ein sinnvolles Erstgespräch kann mit einer kurzen Beschreibung des Auslösers, der manuellen Übergabe, des ungefähren Volumens und der Person beginnen, die Ausnahmen bearbeitet. Senden Sie in der ersten Anfrage keine Zugangsdaten, Kundendatensätze oder uneingeschränkten Produktionszugriff.
Für eine schlüsselfertige Implementierung sollte der vereinbarte Umfang die Prozesslandkarte, Integrationen, Validierungs- und Genehmigungsregeln, Abnahmetests, Rollout, Monitoring und die Übergabe abdecken. Er sollte zudem Ausschlüsse, Drittanbieterkosten und die Supportvereinbarung nach dem Launch definieren. Der erste funktionierende Pfad wird anhand repräsentativer Beispiele getestet, bevor er auf weitere Teams oder Anwendungsfälle ausgeweitet wird. Ob ein bestehender Konnektor oder eine individuelle Komponente geeignet ist, hängt von den tatsächlichen Anforderungen ab, nicht von einer Vorliebe für ein bestimmtes Tool.
Vergleichen Sie Bearbeitungszeit, Korrekturquote, Ausnahmerückstand und laufende Betriebskosten mit der manuellen Ausgangsbasis. Bezeichnen Sie eine Demonstration nicht als gemessene Einsparung. Wenn die vorgeschlagene Automatisierung mehr Prüf- oder Wartungsaufwand erzeugt als sie einspart, grenzen Sie den Umfang ein, wählen Sie eine einfachere Lösung oder stoppen Sie das Vorhaben. Das Ziel ist eine sinnvolle operative Veränderung, kein KI-Feature als Selbstzweck.
Die öffentlichen Automatisierungsbeispiele von YAS zeigen den Unterschied zwischen funktionierenden Produktabläufen und vorgeschlagenen Implementierungen. Wenn Sie Ihren eigenen Prozess besprechen möchten, finden Sie weitere Informationen zur Umsetzung von KI-Automatisierung. Die nächste Entscheidung ist, was als erster Projektumfang geliefert und überprüft werden kann, nicht die Verpflichtung, alles zu automatisieren.
| Prozessname | Komplexitätskategorie | Wichtigste Dateneingaben | Operatives Risikoniveau | Primäre Integrationsmethode |
|---|---|---|---|---|
| Triage im Kundensupport | Umfangsabhängig | Eingehender E-Mail- und Ticket-Text | Hängt von Routing- und Antwortberechtigungen ab | API-basierte Textklassifizierung |
| Bestandssynchronisierung | Mittel | Lagerbestände und Verkaufstransaktionen | Mittel | API-basierte Multi-Channel-Synchronisierung |
| Rechnungsdatenextraktion | Mittel | Unstrukturierte Dokumentdateien | Höher, wenn Buchung oder Zahlung autorisiert ist | OCR und Sprachmodell-Parsing |
| Finanzabstimmung | Hoch | Kontoauszüge und Hauptbuchdateien | Hoch | Benutzerdefinierte Abgleichslogik und ERP-APIs |
| Lead-Klassifizierung | Niedrig | Formulareinsendungen und Kontaktdaten | Hängt von nachgelagerten Aktionen ab | API-basierte Routing-Regeln |
Schritte zur Überprüfung und Einführung Ihrer ersten Automatisierung
- Dokumentieren Sie den ausgewählten Arbeitsablauf Schritt für Schritt, um alle Entscheidungspunkte zu identifizieren.
- Ermitteln Sie die Ausgangsmetriken und häufige Fehlermuster des manuellen Prozesses.
- Definieren Sie klare betriebliche Ziele und interne Parameter für die Automatisierung.
- Erstellen Sie eine erste funktionsfähige Version der Automatisierung mithilfe von APIs oder Werkzeugen zur Ablaufsteuerung.
- Führen Sie die Automatisierung in einer überwachten Sandbox-Umgebung mit Human-in-the-Loop-Validierung aus.
- Führen Sie die Produktivsetzung schrittweise durch und überwachen Sie Randfälle genau.
Bei der Automatisierung geht es nicht darum, menschliche Entscheidungsfindung zu ersetzen; es geht darum, Ihr Team von repetitiven Aufgaben zu entlasten, damit es sich auf wertschöpfende, kreative Problemlösungen konzentrieren kann.
FAQ
Wie erkennen wir, ob ein Prozess bereit für die Automatisierung ist?
Ein Prozess ist bereit für die Automatisierung, wenn er stark repetitiv und regelbasiert ist sowie strukturierte digitale Daten verwendet. Wenn Ihr Team eine klare Schritt-für-Schritt-Anleitung zur Erledigung der Aufgabe verfassen kann, ohne auf subjektives Urteilsvermögen angewiesen zu sein, ist er ein starker Kandidat.
Welche Risiken birgt eine zu schnelle Automatisierung?
Eine zu schnelle Automatisierung ohne angemessene Tests kann zu Systemfehlern, Datenbeschädigung und schlechten Kundenerfahrungen führen. Wenn ein zugrunde liegender Prozess fehlerhaft ist, beschleunigt die Automatisierung lediglich die Rate, mit der Fehler erzeugt werden.
Sollten wir Standardtools verwenden oder individuelle Lösungen entwickeln?
Prüfen Sie bestehende Tools im Hinblick auf die erforderlichen Daten, Berechtigungen, den Durchsatz, die Ausnahmebehandlung und Wartungsvereinbarungen. Nutzen Sie benutzerdefinierten Code für eine spezifische, nicht unterstützte Anforderung. Keiner der beiden Ansätze ist automatisch zuverlässiger oder kostengünstiger; vergleichen Sie die gesamten Betriebskosten und testen Sie das Wiederherstellungsverhalten.
Wie unterscheidet sich KI-Automatisierung von traditionellem RPA?
Regelbasierte Automatisierung folgt festgelegten Bedingungen; KI kann dabei helfen, Text zu interpretieren oder Felder aus Dokumenten vorzuschlagen. Diese Ansätze lassen sich kombinieren. Weder ein KI-Schritt noch eine UI-basierte Automatisierung ist immun gegen Schnittstellenänderungen, fehlende Daten oder fehlerhafte Ausgaben. Wählen Sie den einfachsten Ansatz, der die Akzeptanzkriterien erfüllt.
Wie sieht der typische Zeitrahmen für den Return on Investment bei einer Automatisierung aus?
Der Zeitrahmen für die Beobachtung betrieblicher Veränderungen ist höchst variabel und hängt von der Komplexität des Arbeitsablaufs, dem Transaktionsvolumen und der Genauigkeit der Ersteinrichtung ab. Da jedes Unternehmen individuelle Integrationsanforderungen hat, gibt es keinen garantierten Zeitrahmen für den Return on Investment.
Wie gehen wir mit Bedenken der Mitarbeiter bezüglich der Automatisierung um?
Positionieren Sie Automatisierung als ein Werkzeug, das mühsame, administrative Aufgaben übernimmt und es den Mitarbeitern ermöglicht, sich auf interessantere, höherwertige Projekte zu konzentrieren. Die Einbindung von Teammitgliedern in die Konzeptionsphase hilft ihnen, die direkten Vorteile für ihre tägliche Arbeitslast zu erkennen.
Entscheidungsszenarien
Illustrative Szenarien zur Anwendung des Vorgehens, keine abgeschlossenen Kundenprojekte oder gemessenen Ergebnisse.
Szenario 1: Support-Sortierung: Beginnen Sie mit festgelegten Kategorien und einer Prüfwarteschlange. Bewerten Sie falsch zugeordnete Tickets vor dem automatischen Routing; selbstständige Antworten gehören nicht standardmäßig zum ersten Umfang.
Szenario 2: Content-Briefing: Wenn Kategorien oder Abnahmekriterien im Team unklar sind, klären Sie diese zuerst. Ein Entwurf mit hohem Überarbeitungsbedarf kann Arbeit lediglich verlagern.
Szenario 3: Katalogvorbereitung: Schlagen Sie Attributänderungen mit Quellennachweisen und einem benannten Prüfer vor. Preise, Bestände und Veröffentlichungen bleiben außerhalb des ersten Umfangs, sofern sie nicht separat vereinbart und getestet wurden.