Eine KI-Content-Factory ist eine strukturierte Software-Pipeline, die verifizierte Quelldaten aufnimmt, kontrollierte KI-Generierung über diskrete Schritte anwendet, deterministische Qualitätsprüfungen durchführt und erstellte Entwürfe menschlichen Redakteuren zur Freigabe vorlegt. Anstatt auf einzelne offene Prompts zu setzen, behandelt sie die Content-Erstellung als durchgängigen Engineering-Workflow, der auf hohe redaktionelle Konsistenz und betriebliche Transparenz ausgelegt ist.
Die Illusion des einfachen Prompt-Eingabefelds
In vielen Unternehmen beginnen und enden erste Experimente mit generativer KI innerhalb einer browserbasierten Chat-Oberfläche. Ein Anwender gibt einen ungenauen Prompt ein, erhält einen Rohtext und überarbeitet das Ergebnis manuell, bevor er es in ein Redaktionssystem kopiert. Dieser Ansatz kann zwar einzelne Autoren bei Ad-hoc-Aufgaben unterstützen, taugt jedoch nicht als institutionelles Produktionssystem, da ihm standardisierte Schemavorgaben, Reproduzierbarkeit und überprüfbare Quellenkontrollen fehlen.
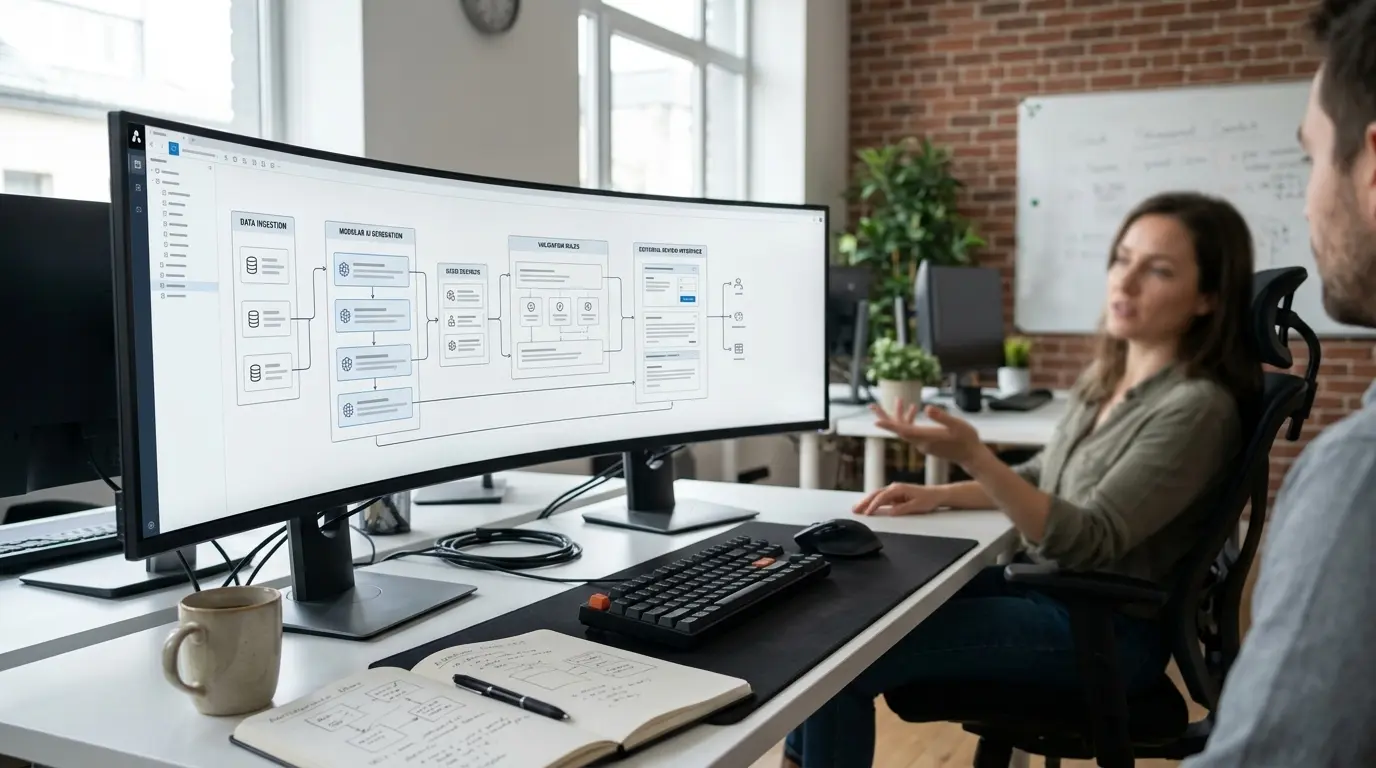
Eine praxistaugliche Produktionspipeline ersetzt unstrukturierte Texteingaben durch standardisierte Datensätze und programmatische Orchestrierung. In einer maßgeschneiderten Pipeline wird die Inhaltserstellung in aufeinanderfolgende Phasen unterteilt: Datenextraktion, kontextuelle Fundierung, modulare Generierung, deterministische Schemavalidierung und strukturierte redaktionelle Prüfung. Jede Phase verfügt über strenge Schnittstellen, Protokollierung und definierte Fehlerbehebungsprozesse.
Wenn Ihr Unternehmen individuelle Pipeline-Entwicklung und durchgängige Workflow-Software benötigt, entdecken Sie unsere maßgeschneiderten KI-Automatisierungsdienste. Maßgeschneiderte KI-Automatisierungsdienste.
Phase eins: Quellenaufnahme und Datenstrukturierung
Jede verlässliche Generierungspipeline beginnt mit kontrollierten Quelldaten. Um technische Dokumentationen, Katalogaktualisierungen oder operative Zusammenfassungen in Enterprise-Qualität zu erstellen, sind verifizierte Quellendaten erforderlich, anstatt sich auf das Trainingsgedächtnis eines KI-Modells zu verlassen. Rohinformationen müssen aus strukturierten Datenbanken, Datenblättern, Kundenticket-Transkripten oder freigegebenen Wissensdatenbanken extrahiert werden.
Nach der Aufnahme parst, normalisiert und validiert das System den Rohtext. Fehlende Metadatenfelder, unbestätigte Faktenbehauptungen oder unvollständige Referenzen werden markiert, bevor überhaupt Text generiert wird. Das Ergebnis ist ein strukturierter Daten-Payload, der ausschließlich verifizierte Attribute, Einschränkungen und Kontextanker enthält, die für nachgelagerte Aufgaben bereitstehen.
Für Teams, die technische Dokumentationen in automatisierte Entwurfssysteme einspeisen möchten, bietet sich unser Leitfaden zur Erfassung verteilten technischen Wissens an. Erfassung verteilten technischen Wissens.
Phase zwei: Zerlegte, modulare Generierung
Der Versuch, ein vollständiges technisches Dokument mit 2.000 Wörtern, einen Katalogeintrag oder einen Wissensartikel in einem einzigen Prompt zu generieren, führt zu Halluzinationen, wiederkehrenden Formulierungen und strukturellem Abdriften. Kontrollierte Pipelines lösen dieses Problem durch die modulare Zerlegung von Aufgaben.
Anstatt einen vollständigen Artikel auf einmal anzufordern, übernehmen spezialisierte Agenten nacheinander eng definierte Aufgaben. Ein Agent erstellt die Gliederung streng auf Basis der verifizierten Daten. Eine zweite Komponente generiert beleggebundene Abschnittsentwürfe. Ein dritter Baustein formatiert strukturierte Tabellen oder Validierungsschemata. Durch die Isolierung jeder einzelnen Aufgabe kann das System aufgabenspezifische Prompt-Einschränkungen und deterministische Ausgabeprüfungen anwenden.
Phase drei: Deterministische Validierung und Regelprüfung
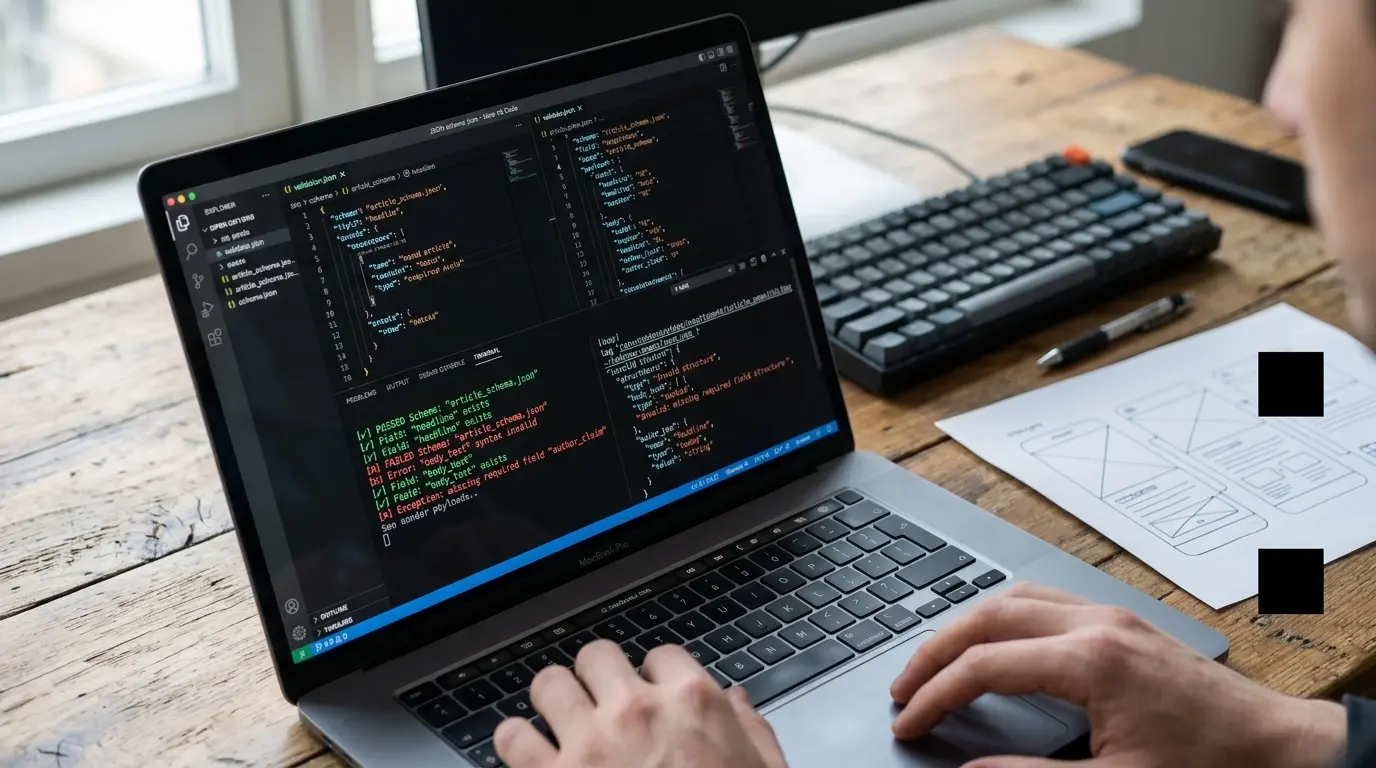
Bevor ein generierter Entwurf menschlichen Prüfern vorgelegt wird, durchläuft er automatisierte Validierungsschichten. Im Gegensatz zu KI-basierten Auswertungen führen deterministische Prüfungen strikte codebasierte Regeln aus, um die Einhaltung von JSON-Schemas, den Ausschluss unzulässiger Begriffe, Wortvorgaben und erforderliche Datenstrukturen zu prüfen.
Erzeugt ein Generierungsschritt eine ungültige Syntax, fehlende Felder oder unautorisierte Aussagen außerhalb des Quell-Payloads, weist die Pipeline die Ausgabe automatisch zurück. Das System kann dann entweder den jeweiligen modularen Schritt mit korrigierten Anweisungen erneut ausführen oder die Rohdaten zur manuellen Prüfung in eine Ausnahmewarteschlange leiten.
Phase vier: Menschliche Prüfung und redaktionelles Routing
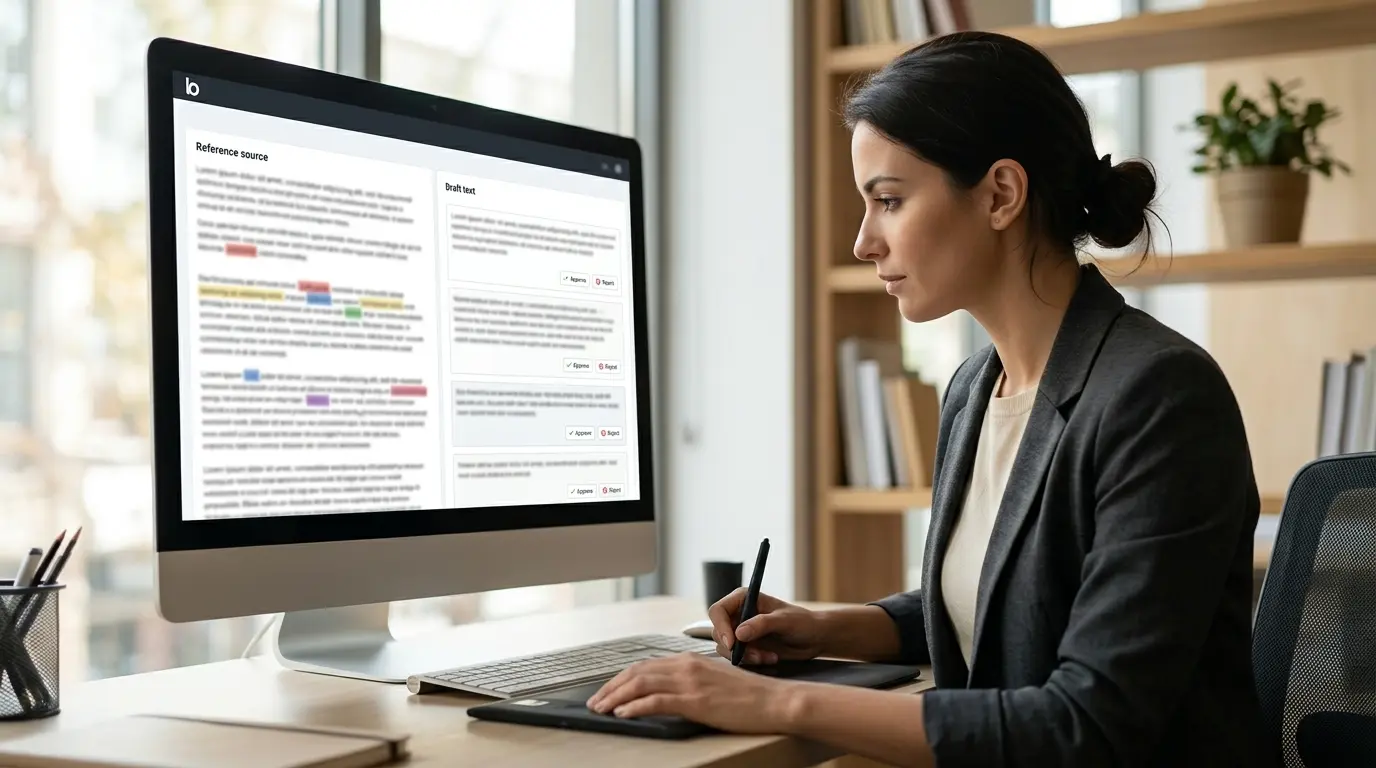
Eine KI-Content-Factory umgeht die menschliche Aufsicht nicht; sie strukturiert und beschleunigt sie. Wenn ein Entwurf alle automatisierten Validierungsschritte besteht, lädt die Pipeline ihn in eine angepasste Prüfumgebung. Anstatt ein leeres Dokument vorzufinden, bewerten Redakteure hervorgehobene Faktenaussagen, prüfen verknüpfte Quelldokumente und geben spezifische Textblöcke frei oder passen diese an.
Prüfoberflächen ermöglichen es Fachexperten, modulare Abschnitte einzeln anzunehmen, zu bearbeiten oder abzulehnen. Freigegebene Datensätze lösen eine automatisierte Serialisierung in die Ziel-Content-Management-Systeme aus, während abgelehnte Abschnitte strukturierte Feedback-Daten liefern, um Pipeline-Anpassungen zu steuern.
Wie spezialisierte Automatisierungsstudios solche Pipelines aufbauen
Die Entwicklung einer durchgängigen Generierungspipeline erfordert eine tiefe Integration über interne Systeme, Daten-Repositories und Veröffentlichungsziele hinweg. Standardlösungen von der Stange fehlen oft die granulare Fehlerbehandlung, individuelle Schemavalidierung und maßgeschneiderte Datenbankanbindungen, die für spezielle betriebliche Anforderungen notwendig sind.
Spezialisierte Automatisierungsstudios wie YAS konzipieren und entwickeln maßgeschneiderte Pipelines von Grund auf. Durch das Erfassen bestehender redaktioneller und technischer Workflows, die Entwicklung individueller Orchestrierungssoftware und die Einbindung von Human-in-the-Loop-Validierungswerkzeugen stellt maßgeschneidertes Engineering sicher, dass sich die resultierende Pipeline nahtlos in Ihre Unternehmensinfrastruktur einfügt.
Um zu verstehen, wie autonome Agentenschritte mit starrem Workflow-Code in Content-Pipelines interagieren, lesen Sie unsere Analyse zum Vergleich von agentenbasierten Ansätzen und Workflow-Automatisierung. Vergleich von agentenbasierten Ansätzen und Workflow-Automatisierung.
Grenzen und Eignung
Eine automatisierte Content-Factory eignet sich nicht für jedes Geschäftsszenario. Sie ist ungeeignet für spekulatives kreatives Schreiben, unbegründete Meinungsbeiträge oder Abläufe, denen strukturierte, verifizierte Referenzdaten fehlen. Wenn Ihre Kerndaten unklar sind oder sich systemübergreifend widersprechen, verstärkt eine automatisierte Generierung lediglich diese Dateninkonsistenzen.
Unternehmen müssen die Qualität ihrer Datenquellen, die API-Stabilität und die redaktionelle Governance überprüfen, bevor sie eine automatisierte Generierungspipeline einführen. Darüber hinaus machen automatisierte Pipelines die Prüfung durch Fachexperten keineswegs überflüssig, noch garantieren sie absolute faktische Genauigkeit ohne kontinuierliche Überwachung und Pflege der Verifikationsprüfungen.
- Prüfen Sie Datenqualität und Zugänglichkeit der Quellen, bevor Sie Generierungs-Workflows entwerfen.
- Definieren Sie explizite Validierungsschemas für jeden Inhaltstyp, um strukturelles Abdriften zu verhindern.
- Etablieren Sie redaktionelle Prüfprotokolle, um Tonalität, Kontext und domänenspezifische Feinheiten zu verifizieren.
Wenn Sie festlegen möchten, welche operativen Workflows in Ihrem Unternehmen zuerst automatisiert werden sollten, nutzen Sie unser Framework zur Identifizierung erster Automatisierungsprozesse. Identifizierung erster Automatisierungsprozesse.
Langfristige Sicherung der Pipeline-Performance
Der Betrieb einer Content-Factory erfordert kontinuierliche Wartung. Da sich zugrundeliegende Modelle weiterentwickeln, können Prompt-Vorlagen subtile Verhaltensänderungen aufweisen, was eine Versionskontrolle und Regressionstests über standardisierte Testsuiten hinweg erfordert.
Teams müssen Ausführungszeiten, Token-Verbrauch, Fehlerraten bei automatisierten Validierungen und Ablehnungsmuster der Redaktion überwachen. Die regelmäßige Auswertung dieser operativen Kennzahlen ermöglicht es Entwicklern, Prompt-Vorgaben zu verfeinern, automatisierte Prüfungen zu erweitern und eine gleichbleibende Ausgabequalität zu sichern.
| Pipeline-Komponente | Hauptfunktion | Ausführungsmechanismus | Fehlerbehandlung |
|---|---|---|---|
| Datenaufnahme | Extrahiert und normalisiert freigegebene Referenzdaten | Deterministische API- und Datenbank-Konnektoren | Payload wird abgelehnt, wenn Pflichtfelder fehlen |
| Modulare Generierung | Erstellt Entwürfe einzelner Inhaltsabschnitte unter strengen Vorgaben | Kontrollierte Ausführung von KI-Agenten pro Schema | Automatischer Neuversuch mit verschärften Prompt-Einschränkungen |
| Deterministischer Validator | Prüft Schema, unzulässige Begriffe und strukturelle Integrität | Codebasierte Validierungsregeln (z. B. JSON-Schema) | Leitet fehlerhafte Entwürfe in eine Ausnahmewarteschlange weiter |
| Redaktionelle Workbench | Ermöglicht menschliche Prüfung und modulare Freigabe | Maßgeschneiderte Human-in-the-Loop-Prüfoberfläche | Manuelle Ablehnung sendet Feedback an die Pipeline-Protokolle |
| Publishing-Dispatcher | Formatiert und synchronisiert freigegebene Entwürfe mit CMS-Endpunkten | Individuelle Webhook- und API-Integrationen | Ausführungsprotokolle alarmieren das Engineering bei Verbindungsabbrüchen |
Schritte zur Implementierung einer durchgängigen KI-Content-Pipeline
- Den gesamten Content-Produktionsprozess abbilden und überprüfbare Datenquellen identifizieren.
- Strenge JSON-Schemas und Validierungskriterien für jedes Zielformat definieren.
- Automatisierte Konnektoren zur Datenaufnahme bauen, um Referenzdokumente zu extrahieren und zu normalisieren.
- Generierungsaufgaben in einzelne modulare Schritte mit spezifischen Prompt-Grenzen zerlegen.
- Programmatische Validierungsprüfungen implementieren, um Formatierungs- und Begriffsregeln durchzusetzen.
- Eine spezialisierte redaktionelle Prüfoberfläche mit Quellabgleichsfunktionen entwickeln.
- Maßgeschneiderte Publishing-Integrationen bereitstellen, um freigegebene Inhalte direkt mit Zielsystemen zu synchronisieren.
Eine praxistaugliche Content-Factory ist eine Engineering-Pipeline: Sie verbindet verifizierte Quelldaten mit modularer Generierung und deterministischen Code-Prüfungen, um verlässliche Ergebnisse zu gewährleisten.
Häufige Fragen
Wie unterscheidet sich eine KI-Content-Factory von herkömmlichen Chat-Tools?
Herkömmliche Tools basieren auf offenen Chat-Prompts in einem Browser und liefern schwankende Ergebnisse ohne Schemabeschränkungen. Eine KI-Content-Factory ist eine strukturierte Software-Pipeline, die die Erstellung in automatisierte Datenaufnahme, modulare Aufgabengenerierung, deterministische Validierungsprüfungen und systematische redaktionelle Prüfungen zerlegt.
Warum ist die Aufgabenzerlegung in Generierungs-Pipelines notwendig?
Die Generierung eines vollständigen Langform-Inhalts in einem einzigen Prompt führt häufig zu Halluzinationen, strukturellem Abdriften und Formatierungsfehlern. Durch die Zerlegung des Prozesses in einzelne Schritte, wie etwa getrennte Aufgaben für Strukturierung, Entwurf und Validierung, werden strenge Begrenzungskontrollen und eine automatisierte Fehlerbehandlung auf jeder Stufe möglich.
Welche Rolle spielt die deterministische Validierung in der Pipeline?
Die deterministische Validierung nutzt programmatische Code-Prüfungen, um sicherzustellen, dass die Ausgaben strikt den geforderten JSON-Schemas, Wortgrenzen und Formatierungsregeln entsprechen. Sie weist fehlerhafte oder unbestätigte Entwürfe automatisch zurück, bevor sie überhaupt an menschliche Redakteure gelangen.
Macht eine automatisierte Content-Pipeline menschliche Redakteure überflüssig?
Nein. Eine automatisierte Pipeline übernimmt die Datenextraktion, Strukturierung, Vorentwürfe und Formatierung, aber menschliche Fachexperten sind unerlässlich, um die fachliche Richtigkeit zu überprüfen, nuancierten Kontext zu beurteilen und die finale Veröffentlichung freizugeben.
Welche Arten von Inhalten eignen sich am besten für eine automatisierte Factory?
Inhaltstypen mit strukturierten Quelldaten und klarer Wiederholbarkeit sind am besten geeignet. Dazu gehören technische Dokumentationen, Produktbeschreibungen, Wissensdatenbank-Artikel und standardisierte operative Berichte, bei denen sachliche Konsistenz entscheidend ist.
Wie können Teams mit maßgeschneiderter Inhaltsautomatisierung starten?
Beginnen Sie damit, bestehende Content-Workflows zu dokumentieren, die Vollständigkeit der Quelldaten zu prüfen und explizite Validierungsregeln zu definieren. Darauf aufbauend können Entwicklungsteams modulare Aufnahme-, Generierungs- und Prüfsysteme entwickeln, die auf spezifische betriebliche Anforderungen zugeschnitten sind.