E-Commerce-Teams skalieren Katalogaktualisierungen, Kundenservice-Abläufe und Bestandsabgleiche durch die Kombination von deterministischer Workflow-Software mit kontrollierten KI-Agenten. Das ausschließliche Vertrauen auf reine Sprachmodelle führt zu Data Drift und unvorhersehbaren Fehlern bei komplexen Produktkatalogen. Maßgeschneiderte Automatisierung verbindet strukturierte Validierungsregeln mit menschlichen Prüf-Warteschlangen und sorgt so dafür, dass hochvolumige Handelsabläufe bei steigendem Bestellvolumen präzise, auditierbar und resilient bleiben.
Operative Engpässe in modernen E-Commerce-Workflows
E-Commerce-Unternehmen, die auf Multichannel-Marktplätzen agieren, stoßen im Backoffice auf erhebliche manuelle Reibungsverluste. Das Onboarding von Produkten erfordert die Übersetzung von Lieferanten-Manifesten in marktplatzkonforme Schemas, die Standardisierung von Attributen und die Validierung von Preisregeln. Werden diese Aufgaben manuell erledigt, verlangsamt das die Markteinführung und führt zu Attributfehlern, die die Sichtbarkeit in der Suche beeinträchtigen.
Der Kundenservice und die Retourenabwicklung stellen ähnliche operative Belastungen dar. Support-Teams verbringen viel Zeit damit, eingehende Rücksendeanfragen mit Versanddienstleister-Ereignissen, ERP-Datensätzen und Regeln zur Bestandsdisposition abzugleichen. Die manuelle Zusammenführung dieser unterschiedlichen Datenquellen führt zu verzögerten Erstattungsentscheidungen und erhöhten Supportkosten.
Der Bestandsabgleich zwischen Warehouse-Management-Systemen und externen Vertriebskanälen birgt weitere Risiken. Bestandsabweichungen zwischen physischem Lagerbestand und Multichannel-Listings können zu Out-of-Stock-Situationen oder nicht erfüllbaren Bestellungen führen. Die Lösung dieser Herausforderungen erfordert eine robuste Integrationsarchitektur anstelle punktueller manueller Dateneingabe.
Planen Sie Entwicklungsinvestitionen mit unserer Übersicht der Kostenfaktoren für Workflow-Automatisierung.
Deterministische Logik im Vergleich zu kontrollierten KI-Agenten
Die Automatisierung von E-Commerce-Workflows erfordert eine klare Trennung zwischen deterministischem Code und probabilistischen KI-Modellen. Deterministische Workflow-Software führt starre Aufgaben wie die Berechnung der Mehrwertsteuer, die Prüfung von Bestandsschwellen und die Synchronisierung von Trackingnummern über APIs aus. Diese Vorgänge erfordern exakte mathematische Präzision und eindeutige Logik, die niemals an Sprachmodelle delegiert werden sollte.
Umgekehrt brillieren kontrollierte KI-Agenten bei der Extraktion unstrukturierter Daten, der semantischen Kategorisierung und der Synthese natürlicher Sprache. Ein KI-Agent kann unstrukturierte Datenblätter von Lieferanten analysieren, fehlende Produktattribute identifizieren oder eingehende Kundenanfragen nach Tonalität und Absicht klassifizieren.
Zuverlässige Handelsarchitekturen stellen jedem KI-Agenten deterministische Schutzmechanismen zur Seite. Die KI liefert strukturiertes JSON, das eine Schemavalidierung durchläuft, bevor es Produktivdatenbanken oder Bestandsbücher erreicht.
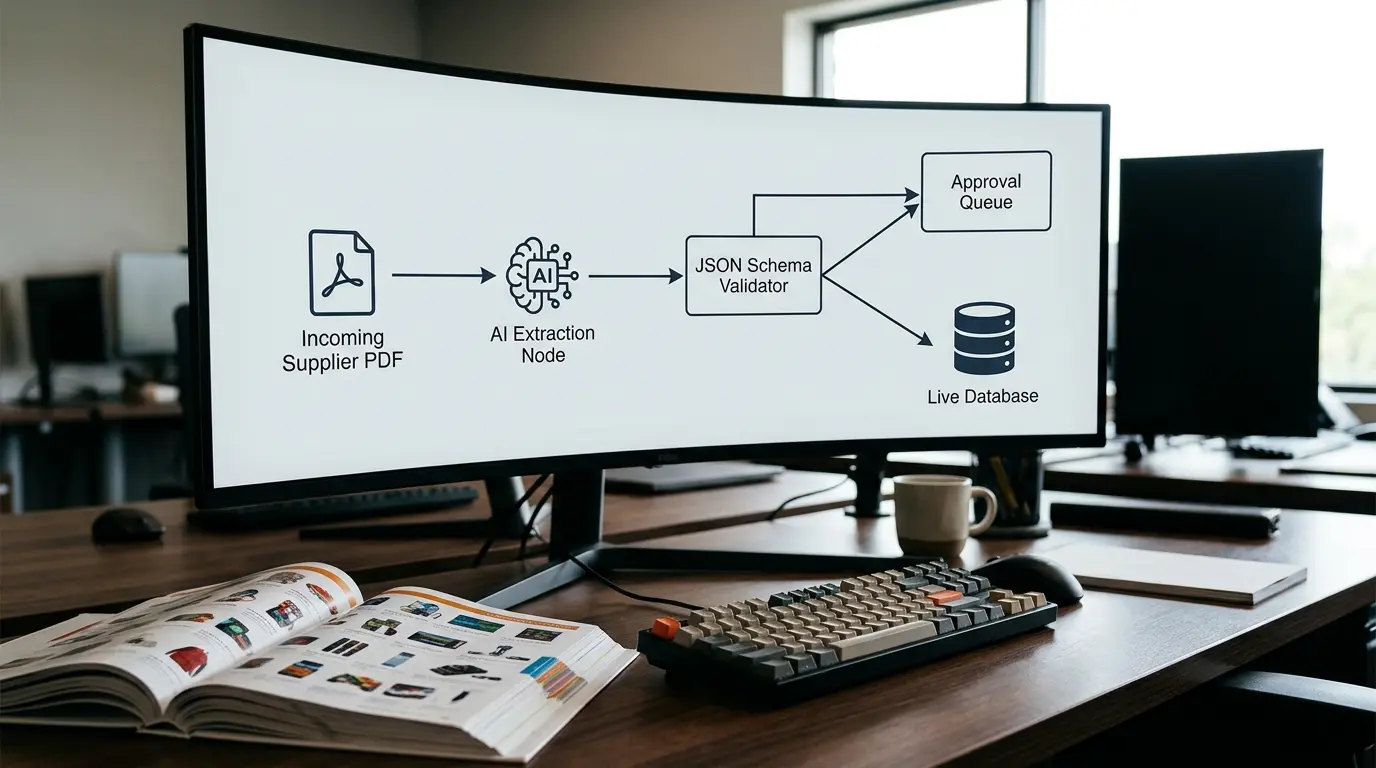
Einen technischen Vergleich finden Sie in unserem Leitfaden: KI-Agenten-Architekturen im Vergleich zu Workflow-Automatisierung.
Bereiche mit hohem Hebel für E-Commerce-Automatisierung
Die Kataloganreicherung stellt eine der wirkungsvollsten Anwendungen für KI-Automatisierung dar. Spezialisierte Agenten extrahieren technische Spezifikationen aus Lieferanten-PDFs, generieren SEO-optimierte Produktbeschreibungen und normalisieren Größen-, Farb- und Kompatibilitätsfelder über Tausende von SKUs hinweg.
Support-Triage kommt infrage, wenn ein Team wiederholt dieselben Anfragetypen identifiziert und denselben Bestellkontext abruft. Ein Assistent kann eine Antwort zur Prüfung vorbereiten. Jeder automatische Versand erfordert explizite Richtlinien und repräsentative Tests; ein vom Modell generierter Konfidenzwert allein reicht zur Autorisierung nicht aus.
Die Verarbeitung von Lieferantenrechnungen und der Abgleich von Bestellungen automatisieren den mehrseitigen Abgleich. Systemintegrationen lesen Lieferantenrechnungen ein, gleichen Posten mit Wareneingangsbelegen ab, markieren Kostenabweichungen und leiten Differenzen direkt an Beschaffungsspezialisten weiter.
Priorisieren Sie den ersten Workflow mit unserem Framework zur Identifizierung geeigneter Automatisierungsprozesse.
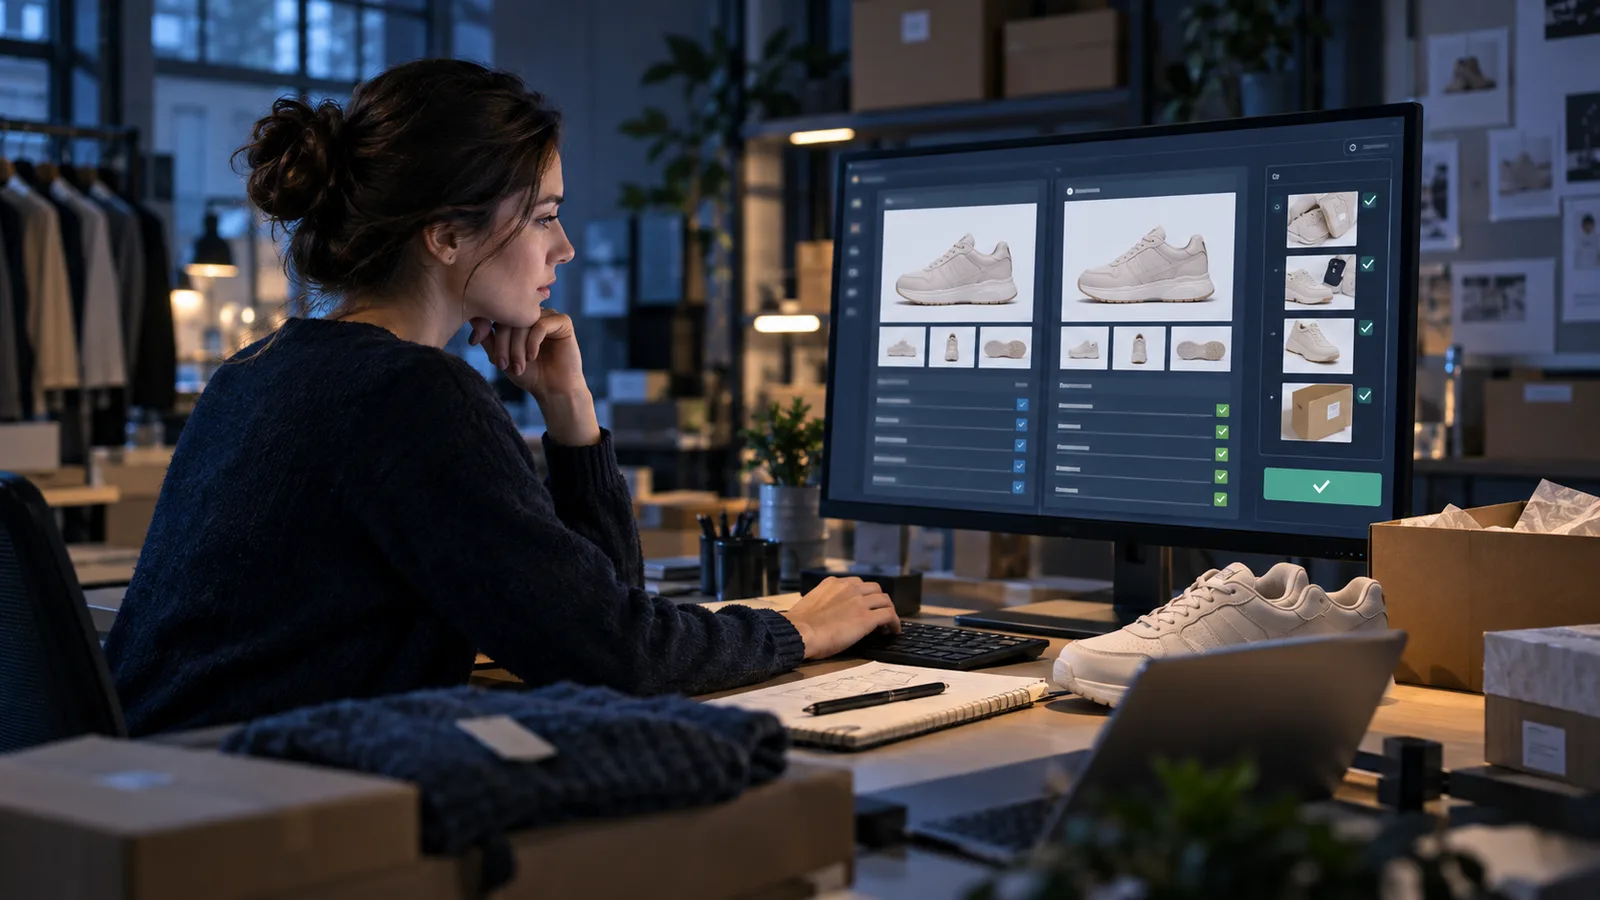
Praxisbeispiel: Von einer Lieferantendatei zur geprüften Katalogaktualisierung
Dies ist ein illustratives Designszenario, kein YAS-Kundenergebnis. Stellen Sie sich ein Team vor, das eine Tabelle und eine PDF-Datei von einem Lieferanten erhält. Der sinnvolle erste Rahmen umfasst eine Produktfamilie und eine kleine, freigegebene Auswahl an Attributen. Preise, Bestandsmengen und Veröffentlichungsberechtigungen bleiben außerhalb dieses Beispiels. Das Ziel besteht darin, ein prüfbares Änderungspaket vorzubereiten – nicht darin, ein Modell den Live-Katalog überschreiben zu lassen.
Nachvollziehbare Eingabedaten sicherstellen
Speichern Sie einen Verweis auf die Lieferantendatei und deren Version und ordnen Sie dann jede Zeile der internen Produktkennung zu. Behalten Sie den Originalwert neben dem vorgeschlagenen, normalisierten Wert bei. Wenn derselbe Lieferantencode zwei Produkten zugeordnet wird, stoppen Sie diese Zeile und weisen Sie die Mehrdeutigkeit aus. Bitten Sie das Sprachmodell nicht, die scheinbar plausibelste Zuordnung zu wählen. Eine fehlende Kennung ist ein Datenproblem, kein Prompt-Problem.
Vorbereitung von der Schreibberechtigung trennen
Der Extraktionsschritt schlägt ein Attribut, dessen Fundstelle und die Information vor, ob die Quelle den Wert tatsächlich enthält. Die Validierung prüft anschließend zulässige Einheiten, Pflichtfelder, Taxonomie-Zugehörigkeit und Widersprüche zu bestehenden, freigegebenen Daten. Wenn sich ein Modell selbst als sicher einstuft, ist das kein Abnahmekriterium. Die prüfende Person benötigt den Quellausschnitt, die vorgeschlagene Änderung und den Grund für die Markierung der Zeile, damit zur Korrektur nicht mehrere Systeme geöffnet werden müssen.
Wiederherstellung testen, nicht nur den Idealfall
Bevor Sie Schreibzugriffe aktivieren, verarbeiten Sie Beispieldatensätze in ein Staging-Änderungsset und vergleichen Sie diese mit einem manuell geprüften Soll-Datensatz. Berücksichtigen Sie eine leere Zelle, eine geänderte Einheit, eine mehrdeutige Produktzuordnung, eine doppelte Datei und eine Änderung, die nach der Extraktion von einem Menschen vorgenommen wurde. Definieren Sie für jeden Fall, ob er abgelehnt, zur Prüfung vorgehalten oder sicher wiederholt werden muss. Eine erfolgreiche Feldvalidierung allein darf keine Veröffentlichung autorisieren.
Bei einer ereignisgesteuerten Integration müssen doppelte Zustellungen und die Wiederherstellung explizit gehandhabt werden; Shopify beschreibt diese Aspekte in seinen Webhook-Richtlinien. Verfolgen Sie den beabsichtigten Vorgang und die Quellversion, prüfen Sie den aktuellen Zielstatus und vermeiden Sie es, eine bereits angewendete Änderung nach einem Timeout erneut auszuführen. Wenn die Plattform ein unklares Ergebnis nicht sicher auflösen kann, halten Sie es für einen Abgleich zurück, anstatt einen Fehler anzunehmen und erneut zu schreiben.
Die Übergabe sollte das Feld-Mapping, Beispielabnahmefälle, Zugriffsgrenzen, einen benannten Verantwortlichen für Ausnahmen und Anweisungen zum Stoppen weiterer Schreibvorgänge umfassen. Protokollieren Sie, welche Aktualisierungen angewendet und welche zurückgehalten wurden. Eine Wiederherstellung kann eine Ausgleichsänderung bedeuten, die gegen den aktuellen Katalog geprüft wird – nicht das blinde Überschreiben einer neueren, legitimen Bearbeitung mit einem alten Wert.
Ein verwandtes öffentliches Beispiel ist der Ablauf zur Eingabe von Produktfotos und zur Prüfung generierter Assets in My UGC Studio. Es veranschaulicht eine andere E-Commerce-Aufgabe: die Vorbereitung von visuellem Material zur Prüfung. Es ist kein Beweis dafür, dass diese Katalogintegration existiert, und belegt keine Umsatzsteigerung. Beachten Sie die Unterschiede zwischen öffentlichen Produkt-Workflows und vorgeschlagenen Pilotprojekten in den YAS-Automatisierungsbeispielen.
Human-in-the-Loop-Architektur und Ausnahmebehandlung
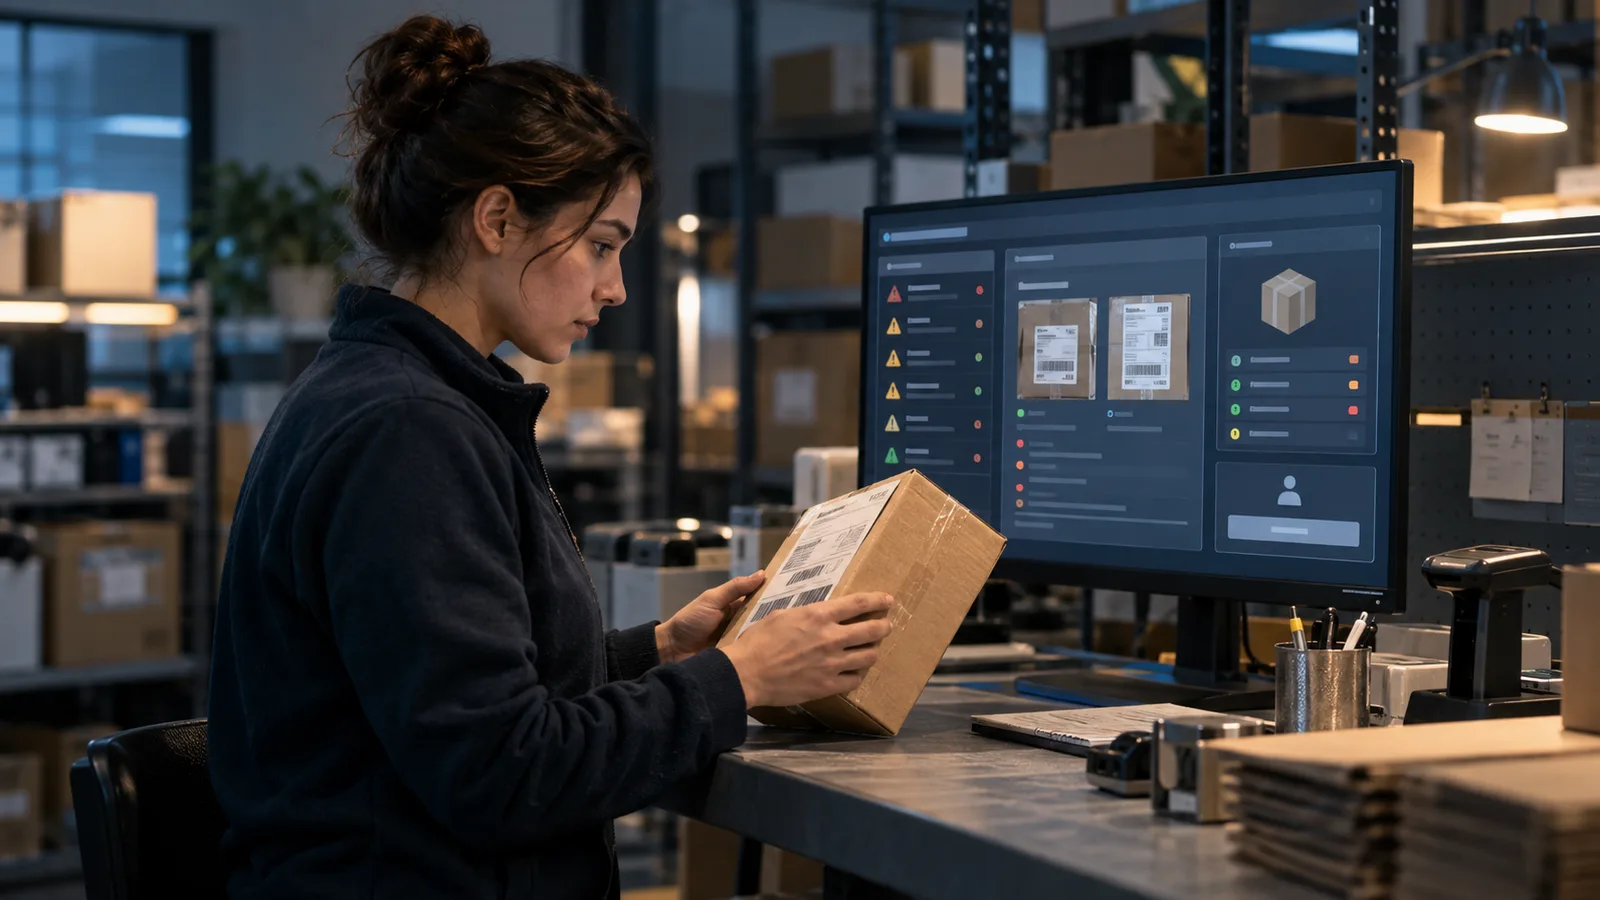
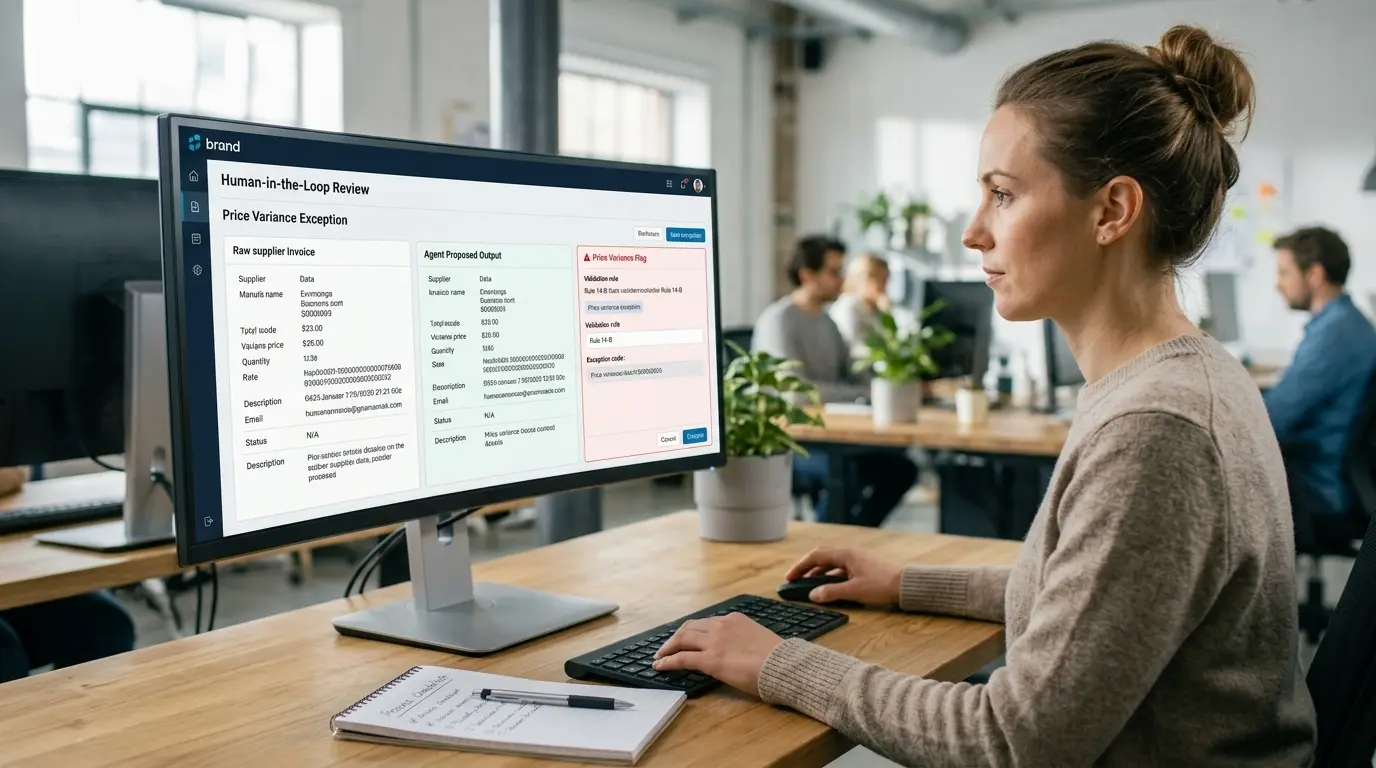
Eine autonome Ausführung ohne menschliche Aufsicht birgt erhebliche operative Risiken für Handelsmarken. Ein robustes Human-in-the-Loop-Framework leitet mehrdeutige Daten, unsichere Agenten-Schlussfolgerungen und anomale Transaktionen in dedizierte Prüfoberflächen.
Ausnahmebehandlungssysteme erfassen Randfälle, bevor sie das Kundenerlebnis oder die finanzielle Integrität beeinträchtigen. Schlägt ein KI-Agent beispielsweise eine Produktpreisänderung vor, die außerhalb einer festgelegten Toleranz liegt, stoppt das System die Ausführung und benachrichtigt einen Operations Manager.
Prüfoberflächen sollten dem Bedienpersonal den vollständigen operativen Kontext anzeigen: die Rohdaten des Lieferanten, die vorgeschlagene Agentenausgabe und die spezifische Validierungsregel, die die Prüfung ausgelöst hat. Korrekturen der Operatoren können anschließend protokolliert werden, um System-Prompts und Validierungslogik im Laufe der Zeit zu verfeinern.
Datenqualität, Validierungsregeln und Systemintegration
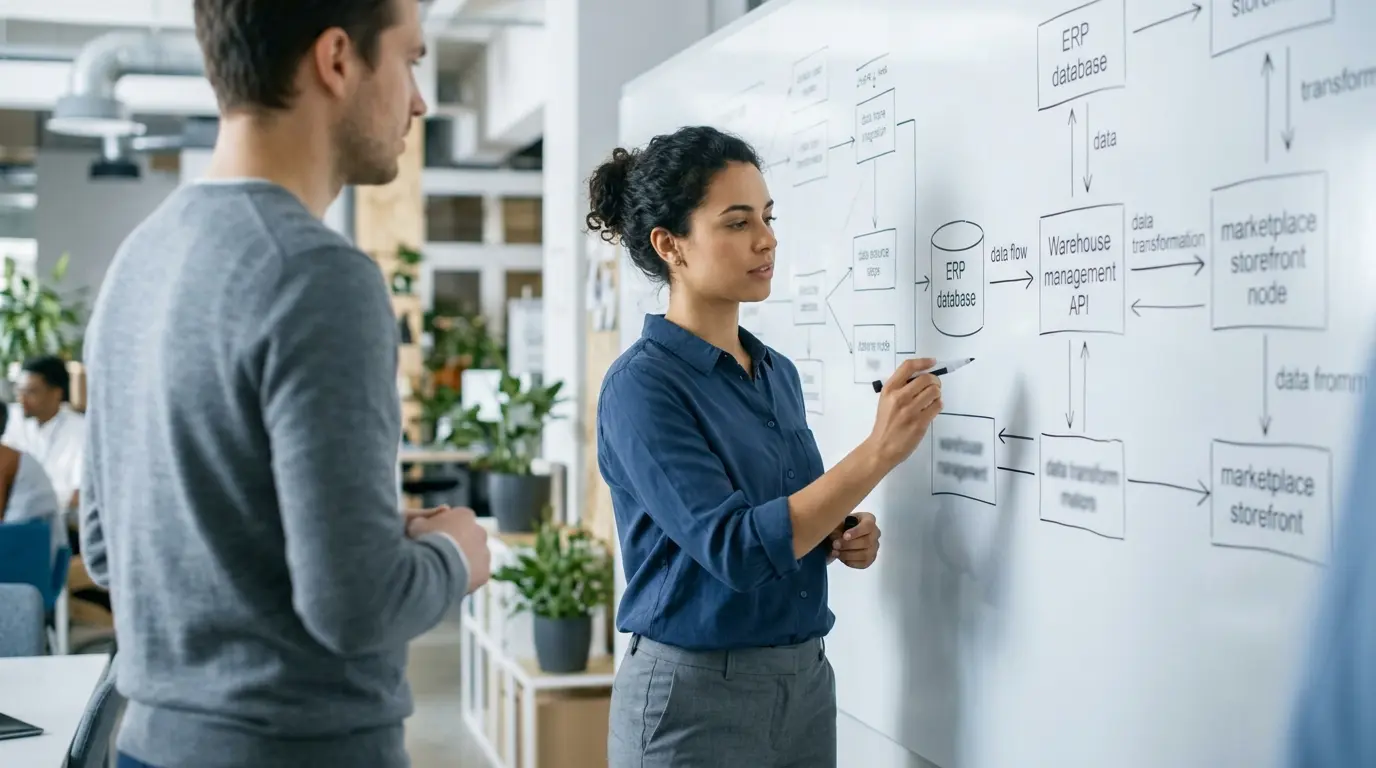
Individuelle Workflow-Automatisierung verbindet ERP-Systeme, Lagerverwaltungsplattformen, Zahlungsgateways und Marktplatzkanäle zu einer zusammenhängenden Pipeline. Eine API-Integration kann wiederholte Exporte und Uploads reduzieren, wenn Berechtigungen, Datenabdeckung, Ratenbegrenzungen und Wiederherstellungsverhalten zum Workflow passen. Ein zeitgesteuerter Dateiaustausch kann für Systeme ohne passende API weiterhin angemessen sein.
Datenvalidierungsschichten setzen an jeder Schnittstelle strenge Schemadefinitionen durch. Typprüfungen und Referenzvalidierungen decken spezifizierte strukturelle Probleme auf. Sie beweisen jedoch nicht, dass ein Lieferantenwert fachlich korrekt ist; Maßeinheiten, Quellherkunft, freigegebene Taxonomien und feldübergreifende Konsistenz erfordern separate Prüfungen.
Zentralisierte Audit-Logs gewährleisten die lückenlose Nachvollziehbarkeit jeder automatisierten Aktion. Der Prüfpfad sollte die Quellversion, die Transformation, das Validierungsergebnis, die Freigabe und die Aktualisierung im Zielsystem miteinander verknüpfen. Speichern Sie nur die für die Diagnose erforderlichen Daten mit entsprechenden Zugriffskontrollen und Aufbewahrungsfristen, anstatt Kundendaten wahllos zu protokollieren.
Informationen zum Implementierungsumfang und zur Betriebsverantwortung finden Sie bei YAS: Individuelle KI-Automatisierungsdienste.
Einschränkungen und Eignung
KI-Automatisierung eignet sich nicht für stark volatile Prozesse, denen es an definierten Geschäftsregeln oder grundlegender operativer Stabilität fehlt. Wenn ein Unternehmen seine zentralen Katalogtaxonomien oder Rückgaberichtlinien nicht dokumentiert hat, verstärkt der Einsatz automatisierter Agenten bestehende Prozessmängel, anstatt sie zu beheben.
Eigenständige KI-Agenten ohne Integrations-Middleware können keine Datenkonsistenz über verteilte E-Commerce-Systeme hinweg garantieren. Teams müssen sicherstellen, dass ihre zugrunde liegenden Softwareplattformen zugängliche APIs oder Datenbank-Webhooks bereitstellen, um eine zuverlässige ereignisgesteuerte Automatisierung zu unterstützen.
Unternehmen müssen klare operative Verantwortlichkeiten für automatisierte Systeme festlegen. Laufende Überwachung, Prompt-Anpassungen, Schema-Aktualisierungen und das Management von Ausnahme-Warteschlangen erfordern dedizierte operative Betreuung, um die langfristige Zuverlässigkeit zu sichern.
Den ersten Prozess auswählen und ein nützliches Briefing erstellen
Ich würde mit dem Prozess beginnen, dessen Input, Verantwortlicher und akzeptables Ergebnis sich heute nachweisen lassen. Eine abgegrenzte Aufgabe zur Katalogaufbereitung ist ein besserer Ausgangspunkt als das Versprechen, alle Handelsabläufe zu automatisieren. Wenn der Großteil der Arbeit darin besteht, undokumentierte Richtlinienfragen zu klären, müssen diese Entscheidungen zuerst getroffen werden. Wenn der Prozess bereits schnell und stabil läuft, übersteigen die Wartungskosten möglicherweise den Nutzen des KI-Einsatzes.
Beschreiben Sie für ein nützliches Erstgespräch den Auslöser, die beteiligten Tools, den wiederkehrenden manuellen Schritt und was passiert, wenn der reguläre Pfad fehlschlägt. Nennen Sie das ungefähre Volumen und die Person, die Ausnahmen bearbeitet. Sie müssen kein KI-Modell auswählen und keine technische Spezifikation erstellen. Nutzen Sie anonymisierte Beispiele oder eine einfache Prozessbeschreibung; senden Sie bei einer ersten Anfrage keine Kundendatensätze, Zugangsdaten oder uneingeschränkten Produktionszugriffe.
Vereinbaren Sie die Abnahmekriterien für die erste Implementierung, bevor Sie einen größeren Rollout planen. Vergleichen Sie die Bearbeitungszeit der Operatoren anhand einer repräsentativen Stichprobe, den Anteil der korrekturpflichtigen Datensätze, das Alter ungelöster Ausnahmen sowie die laufenden Kosten für APIs, Prüfung und Support. Halten Sie die Zusammensetzung der Stichproben vergleichbar. Ein schnellerer Extraktionsschritt ist keine Ersparnis, wenn Operatoren nachgelagert mehr Zeit damit verbringen, dessen Ausgabe zu reparieren.
Ein schlüsselfertiger Projektumfang sollte die Zuständigkeiten nach dem Start explizit regeln: welche Integrationen und Umgebungen enthalten sind, wie Änderungen genehmigt werden, wo Fehler sichtbar werden, wer die Verarbeitung anhalten kann und was der Support abdeckt. Fragen Sie nach Ausschlüssen ebenso wie nach Lieferergebnissen. Ein breiterer Rollout folgt auf Belege aus dem ersten funktionierenden Pfad, nicht auf einer angenommenen prozentualen Verbesserung.
Wenn Sie eine wiederkehrende Aufgabe und deren gewünschtes Ergebnis beschreiben können, bringen Sie dies in ein Gespräch über die Implementierung von KI-Automatisierungein. Die nächste sinnvolle Entscheidung ist, ob die Aufgabe für eine abgegrenzte Implementierung bereit ist, eine Prozessklärung erfordert oder besser durch bestehende Software bedient wird.
Entwicklung individueller Automatisierung mit YAS
YAS konzipiert und baut maßgeschneiderte End-to-End-Automatisierungslösungen, die auf individuelle Betriebsabläufe zugeschnitten sind. Die Umsetzung kann bestehende Konnektoren, Workflow-Tools und individuelle Komponenten kombinieren. Die Wahl hängt vom Prozess, den Zuverlässigkeitsanforderungen, den verfügbaren Integrationen und der späteren Wartung ab.
Unser Entwicklungsansatz konzentriert sich auf Prozessneugestaltung, strenge Datenvalidierung, menschliche Prüf-Warteschlangen und robuste Ausnahmebehandlung. Ziel ist es, definierte repetitive Arbeit zu reduzieren und gleichzeitig die nachvollziehbare Prüfung wichtiger Entscheidungen zu wahren. Der Abnahmetest muss zeigen, was sich tatsächlich geändert hat; eine reine Demonstration ist kein Beweis für Zeitersparnis.
Durch die Strukturierung von Backoffice-Datenflüssen und die Automatisierung manueller Datentransformationen hilft YAS E-Commerce-Unternehmen dabei, skalierbare, auditierbare und widerstandsfähige Geschäftsprozesse zu etablieren.
Vergleichen Sie die Implementierungsoptionen in unserem Leitfaden: Maßgeschneiderte Workflow-Softwareentwicklung.
| E-Commerce-Prozess | Automatisierungsmechanismus | Primärer Kontrollmechanismus | Auslöser für manuelle Prüfung |
|---|---|---|---|
| Lieferantenkatalog-Import | Kontrollierte KI-Attributextraktion | Schema- und Typprüfung | Nicht zugeordnete Taxonomie oder fehlende Felder |
| Kundenretouren-Triage | NLP-Absichtsklassifizierung & API-Abfrage | Richtlinienprüfung und menschliche Freigabe | Richtlinienabweichung oder Retourenwert übersteigt Limit |
| Sendungsverfolgungs-Updates | Deterministischer Webhook & Versanddienstleister-Abgleich | Idempotenz & Statusprüfung | Zustellausnahme des Dienstleisters oder verlorenes Paket |
| Lieferantenrechnungsabgleich | Mehrseitiger Dokumentenabgleich | Preisabweichungstoleranz | Diskrepanz zwischen Bestellung und Wareneingang |
| Lagerbestandsausgleich | Deterministischer ERP- & Kanalabgleich | Sicherheitsbestand-Untergrenzen | Negativer Bestand oder starker Bestandsdrift |
Schrittweiser Implementierungsleitfaden für Handelsautomatisierung
- Erfassen Sie bestehende Workflows in Katalogmanagement, Fulfillment und Kundensupport, um Engpässe bei der manuellen Dateneingabe zu identifizieren.
- Definieren Sie klare Grenzen zwischen deterministischen mathematischen Aufgaben und probabilistischen Aufgaben der natürlichen Sprachverarbeitung.
- Etablieren Sie strukturierte JSON-Schemas und Datenvalidierungsregeln für alle externen Dateneingänge.
- Implementieren Sie dedizierte Prüf-Warteschlangen und Benutzeroberflächen für die Human-in-the-Loop-Ausnahmebehandlung.
- Bauen Sie direkte API-Integrationen zwischen ERP-, WMS- und E-Commerce-Storefront-Plattformen auf.
- Setzen Sie kontrollierte KI-Agenten mit eingegrenzten System-Prompts und strikter Konfidenzbewertung ein.
- Richten Sie automatisiertes Audit-Logging und Echtzeit-Warnungen für fehlgeschlagene Ausführungsschritte ein.
- Überwachen Sie die Bearbeitungszeiten in den Ausnahme-Warteschlangen und verfeinern Sie die Validierungslogik kontinuierlich auf Basis der Operatoreneingaben.
Maßgeschneiderte Automatisierung ist im Handel dann erfolgreich, wenn probabilistische Sprachmodelle an deterministische Validierungsregeln und transparente menschliche Prüfkontrollen gebunden sind.
Häufig gestellte Fragen
Was ist der Unterschied zwischen KI-Agenten und deterministischer Workflow-Software im E-Commerce?
Deterministische Workflow-Software führt feste, regelbasierte Abläufe wie Steuerberechnungen und Bestandssynchronisierungen mit exakter Präzision aus. KI-Agenten verarbeiten unstrukturierte Informationen wie Lieferantenspezifikationen oder Kunden-E-Mails und wandeln qualitative Eingaben in strukturierte Daten für die nachgelagerte Ausführung um.
Wie schützen Human-in-the-Loop-Kontrollen E-Commerce-Abläufe?
Validierungsregeln können bestimmte Anomalien und Richtlinienausnahmen in Prüf-Warteschlangen leiten, bevor eine Aktualisierung autorisiert wird. Das reduziert Risiken, fängt aber nicht jede fehlerhafte Modell-Schlussfolgerung ab. Testen Sie sowohl die fälschliche Annahme als auch die fälschliche Ablehnung und legen Sie fest, wer eine Änderung genehmigen oder ein unklares Ergebnis auflösen darf.
Wie sollte die Automatisierung mit inkonsistenten Lieferantendaten umgehen?
Beginnen Sie mit repräsentativen Dateien, einschließlich unvollständiger und widersprüchlicher Beispiele. Die Extraktion kann bei der Vorbereitung von Attributen helfen, aber Validierung, Quellennachweise und eine Ausnahme-Warteschlange sind weiterhin erforderlich. Fehlende Werte sollten als unbekannt markiert bleiben, bis sie bestätigt sind, anstatt erfunden zu werden, um ein Schema zu erfüllen.
Wann ist ein E-Commerce-Prozess für KI-Automatisierung ungeeignet?
Prozesse ohne dokumentierte Geschäftsregeln, etablierte Taxonomien oder stabile Basissysteme sind für eine Automatisierung ungeeignet. Die Automatisierung eines instabilen oder undefinierten Workflows verstärkt Fehler, anstatt operative Reibung abzubauen.
Wann ist eine individuelle Integration anstelle eines bestehenden Konnektors erforderlich?
Verwenden Sie einen bestehenden Konnektor, wenn er die erforderlichen Daten, Berechtigungen, Durchsätze, Wiederherstellungsmechanismen und betrieblichen Zuständigkeiten unterstützt. Ergänzen Sie individuellen Code für spezifische, nicht abgedeckte Anforderungen, wie etwa domänenspezifische Validierungsregeln oder Ausnahme-Oberflächen. Individuelle Integrationen unterliegen weiterhin den Limits vorgelagerter APIs und erfordern Wartung; sie sind nicht automatisch zuverlässiger.